Single-cell RNA sequencing
单细胞 RNA 测序
从一个肺组织问题出发,沿细胞、分子、矩阵、关系、身份、比较、动态推断与实验验证,建立完整的单细胞科研判断链。
- INPUT
- Tissue / Cell suspension · FASTQ · Gene × Cell Matrix
- OUTPUT
- Annotated cells · Donor-level comparisons · Testable hypotheses
- FIGURES
- QC / UMAP / DotPlot · Pseudobulk / Composition / GSEA · Trajectory / Network / Validation ladder
学完这一章,你应该能够
点击勾选不是“完成任务”,而是对自己的理解做一次承诺。
先建立一张不会迷路的单细胞地图
这不是软件按钮清单。你会反复回答:现在的数据对象是什么、统计单位是谁、图能支持什么、什么时候必须停止。
GSE135893 · 人肺纤维化公开数据主线
主线使用 GSE135893 processed matrix 与公开元数据的轻量派生物。矩阵缓存不进入 Git;浏览器只提交固定种子分层子集,疾病比较仍以 donor 为统计单位。Velocity/Fate 仅用公开胰腺辅助案例,不作为肺纤维化证据。
查看 GEO 数据页 →单细胞 RNA 测序:先建立全局地图,再进入细节
先理解细胞、捕获协议和分子计数,再进入矩阵、邻居图与细胞注释。
为什么要把细胞作为测量单位?
组织平均值会混合细胞比例和细胞状态。单细胞测量把表达信号重新绑定到细胞身份。
Bulk 像听全班合唱,scRNA-seq 像为每位学生分别录音;分开后才能知道是谁改变了音量。
类比只帮助理解,不作为科研证据。- 1细胞类型、状态和比例是三个不同问题
- 2独立样本仍是患者、动物或培养物,而不是细胞数
从“生命的构成单元”到可解释的单细胞数据
把实验原理、测序技术、协议选择和数据分析串成一条可追溯的证据链。以下内容是对参考教程知识范围的原创改写,适合在进入 Pipeline 前建立背景。
0101 · MEASUREMENT UNIT为什么把细胞当作测量单位?
细胞不是被动的容器,而是维持稳态、响应刺激并执行功能的开放系统。组织样本把许多细胞混在一起后,测到的是它们共同贡献的平均信号;这个平均值可能同时包含细胞比例变化和细胞状态变化。
因此,scRNA-seq 的第一步不是“画 UMAP”,而是先问:研究问题是否需要知道是哪一类细胞在变化?如果问题只关心整个组织的平均转录反应,Bulk RNA-seq 可能更简单;如果问题涉及稀有细胞、细胞状态或细胞间异质性,单细胞分辨率才有额外价值。
- 细胞类型:谁在样本里?
- 细胞状态:同一类型的细胞是否处于不同状态?
- 细胞组成:疾病或治疗是否改变了不同细胞的比例?
- 证据边界:单细胞揭示关联与异质性,不自动证明机制或因果。
本节要带走:把“组织平均值”拆成“细胞身份、细胞状态和细胞比例”三个问题,才知道单细胞是否值得增加实验复杂度。
0202 · TECHNOLOGY CONTEXT测序技术为什么会影响你能看到的结果?
Sanger、短读长高通量测序和长读长测序并不是简单的“旧版、升级版、最新版”。它们在读长、通量、错误模式、成本和是否需要扩增等方面不同,所以会改变哪些分子更容易被看见。
对于 scRNA-seq,实验协议和测序平台共同决定捕获的是完整转录本,还是带有细胞 barcode 与 UMI 的 3′/5′ 标签。分析时如果忽略这些前置差异,很容易把协议偏差误认为细胞生物学。
- 第一代:单片段、低通量、读长有限但单次结果可精读。
- 第二代:短读长、高通量、适合大规模计数,但依赖文库和参考序列。
- 第三代:读长更长,可减少组装歧义或直接读取部分修饰,但错误模式和成本需要单独评估。
本节要带走:选平台时先写出目标测量对象:基因计数、异构体、融合、变异,还是完整转录本;不同目标对应不同的可见性和代价。
0303 · FROM MOLECULE TO FILENGS 如何把分子变成可分析文件?
无论是 DNA 还是先经过逆转录的 RNA,NGS 都可以理解为一条从样本到信号、再到文件的链条:文库准备把分子变成可读取的结构,扩增和测序产生信号,软件把信号转换成 reads 与质量值。
FASTQ 不是“表达矩阵的另一种写法”,而是仍然保留单条 read、碱基和 Phred 质量的原始观测。Cell Ranger 或其他定量流程会再利用 barcode、UMI、参考基因组和注释文件,把 reads 归属到细胞与基因。
- 样本与文库:裂解、逆转录、接头连接和扩增。
- 测序输出:碱基序列、质量分数以及 barcode/UMI 读段。
- 计算定量:校正 barcode、去重 UMI、比对或伪比对,并生成矩阵。
本节要带走:看到一个矩阵数字时,始终可以反向追问:它来自哪条 read、哪个 barcode、哪个 UMI,以及哪一版参考注释?
0404 · RNA MEASUREMENTRNA-seq 在测量什么?
DNA 序列描述的是相对稳定的遗传信息,RNA-seq 更像在某个时间点拍摄细胞正在使用哪些转录本的快照。RNA 通常先被逆转录为 cDNA,再进入文库准备和测序,因此最终信号同时受到生物学表达、捕获效率、扩增和测序深度影响。
RNA-seq 可以支持基因表达、剪接、融合和部分变异问题,但每一种结论都依赖相应的设计与定量对象。一个基因的 reads 增多,不等于蛋白质活性、细胞功能或疾病因果已经被证明。
- 表达量是对观测到的分子或 fragments 的统计估计,不是细胞内分子的直接清点。
- 参考基因组、转录本注释和比对策略会改变可计数对象。
- 技术重复与生物学重复回答不同问题,不能用更多细胞观测替代独立样本。
本节要带走:先定义 estimand(要估计的对象),再选择测序和统计方法;不要从一张表达图反推实验没有测量的分子层级。
0505 · WHAT SINGLE-CELL ADDSscRNA-seq 相比 Bulk 多了哪些环节?
单细胞实验仍然包含裂解、逆转录、扩增、文库和测序,但在此之前还必须把细胞分离并把每个转录组绑定回一个细胞身份。液滴、孔板或芯片的分隔方式决定了规模、捕获效率、成本和可追踪的分子信息。
分辨率提高同时也提高了错误解释的机会:低质量细胞、doublet、环境 RNA、解离应激和批次差异都可能产生看似有意义的群体。因此“得到更多细胞”不等于“得到更多可信证据”。
- 分离:把细胞放进彼此可区分的反应单元。
- 标记:用 cell barcode 识别细胞,用 UMI 近似识别原始分子。
- 恢复:捕获只是部分转录本,检测概率随基因、细胞类型和协议而变。
- 分析:从稀疏矩阵推断邻居、群体、marker 与状态,而不是直接读取“真实类型”。
本节要带走:scRNA-seq 的新增价值来自“细胞身份与表达谱绑定”,新增风险也来自分离、标记和稀疏观测本身。
0605.2 · TRANSCRIPT QUANTIFICATION全长与标签协议:你到底在数什么?
全长协议尝试覆盖转录本的更多区域,通常更适合研究异构体或完整转录本结构;标签协议主要捕获转录本的 3′ 或 5′ 端,牺牲覆盖范围来换取更高通量、cell barcode 和 UMI 的规模化计数。
PCR 会把一个原始分子复制成许多拷贝,如果没有分子层面的标识,拷贝数可能被误当成原始分子数。UMI 必须在扩增前加入,去重时也要考虑测序错误、基因位置和 barcode 纠错,而不是机械地按相同序列删除。
- 全长:覆盖更广,适合异构体与转录本结构;但通常细胞规模更小、成本更高。
- 标签:适合大规模细胞图谱和 UMI 计数;但不应把 3′/5′ 标签数据解释成完整转录本表达。
- 扩增偏差:高表达、短基因、GC 含量和捕获位置都可能改变检测概率。
本节要带走:先看协议的捕获对象和 UMI 设计,再解释矩阵中的“表达量”;协议名称本身不是质量结论。
测序历史不是“旧版 → 新版”,而是测量对象的取舍
读长、通量、错误模式和成本会改变“哪些分子更容易被看见”。
链终止与单片段精读
适合验证短片段或单个候选序列;通量和自动化能力有限。
短读长高通量计数
以大量 reads 换取规模和覆盖,Illumina 等平台成为常见 RNA-seq/scRNA-seq 读出。
长读长与实时读取
PacBio 与 Oxford Nanopore 等平台可提供更长的分子观察,并在部分场景减少拼接歧义。
完整转录本与 3′/5′ 标签:先问你要测什么
同样叫 RNA-seq,捕获策略不同,能支持的问题也不同。
Full-length 全长
尽量覆盖单个转录本的多个区域- 可以回答
- 异构体与剪接结构;较完整的转录本覆盖
- 代价与偏差
- 细胞数量通常较少;文库和测序成本较高
- 如何选择
- 当问题是转录本结构、剪接或候选基因全长变化时优先考虑;不要用它的深度优势冒充大规模细胞图谱。
3′/5′ Tag 标签
主要读取转录本一端,并附带 cell barcode 与 UMI- 可以回答
- 大规模细胞并行;分子去重与细胞级计数
- 代价与偏差
- 不代表完整转录本覆盖;低表达、短转录本和捕获偏好仍会影响检测
- 如何选择
- 当问题是组织组成、细胞状态和稀有群体时通常更实用;解释异构体时必须换用合适协议或独立验证。
液滴、孔板和芯片:协议本身就是证据的一部分
没有一种协议在所有研究问题上都最好;规模、细胞状态、稀有群体和转录本信息需要一起权衡。
高通量:适合数千到数万细胞并行规模大;通常支持 UMI 和细胞图谱捕获到的转录本比例有限;doublet、空液滴和环境 RNA 需要 QC信号:细胞大小或膜状态影响进入液滴;短基因/高 GC 或捕获效率差异影响检测;稀有细胞可能在解离与 cell calling 中丢失需要组织组成、稀有群体或多个样本的细胞级图谱,并能接受标签化 3′/5′ 计数。
中低通量:通常数百到数千细胞单细胞转录本检测更深;可结合 FACS 选择细胞或做多级 barcode每个细胞成本和操作负担更高;细胞数较少,稀有群体覆盖受限信号:预先分选改变了样本组成;孔间批次与低输入效应;没有被分选到的细胞不会出现在图谱中问题需要较高转录本覆盖、候选细胞的全长/异构体信息,或实验需要先按表面标记富集。
有限规模:依赖芯片规格和专用仪器每个细胞可获得较深的转录组覆盖;反应条件高度集成仪器、芯片和试剂成本较高;规模与灵活性低于开放式液滴方案信号:加载成功率与细胞大小相关;专用芯片造成的批次结构;不适合直接推断大规模组织组成目标是较深的单细胞转录本观测,且实验室已有设备并能接受有限通量。
从分子到结论:每一步都改变可回答的问题
这条桥接链连接参考教程的“数据分析”部分与本课程后面的交互式 Pipeline。
- 1分离与文库Tissue → cell / nucleus suspension
能问:哪些细胞被实际送入测序?
别忘:解离应激、细胞损失和富集步骤已经改变了样本组成。
- 2Barcode + UMIcell barcode / molecular tag
能问:如何把 read 归回细胞和原始分子?
别忘:barcode 错误、UMI 碰撞和 PCR 扩增会影响去重。
- 3FASTQreads + base quality
能问:测序仪实际读到了什么?
别忘:FASTQ 仍是原始观测,不是基因表达矩阵。
- 4定量与矩阵Gene × Cell sparse matrix
能问:哪些 reads 被计入哪个基因?
别忘:参考注释、比对策略和 cell calling 会改变矩阵。
- 5QC 与表示QC metrics → normalized/HVG/PCA
能问:哪些观测足以进入比较?
别忘:固定阈值和直接使用 raw counts 都会把技术尺度带进表示。
- 6邻居、聚类与 UMAPneighbor graph → communities / coordinates
能问:哪些细胞表达状态相近?
别忘:UMAP 是表示,cluster 是图上的社区;二者都不等于真实细胞类型。
- 7注释与下游分析markers + reference + sample metadata
能问:如何提出可复核的生物学解释?
别忘:单个 marker、单张图和单个 p 值都不能独立完成注释或因果推断。
一份组织,是怎么变成可解释 Figure 的?
点击任意节点,追踪 WHY、INPUT、PROCESS、OUTPUT、PARAMETERS、QC、COMMON ERROR 和 NEXT。
QC
细胞质量控制
坏细胞和 doublet 也会进入矩阵,并可能制造假 cluster 或 marker。
坏细胞和 doublet 也会进入矩阵,并可能制造假 cluster 或 marker。
Gene × Cell Matrix
联合观察基因数、UMI、线粒体比例、doublet 与样本分布。
保留的高可信细胞
数据对象改变,能回答的问题也在改变
文件、稀疏矩阵、低维表示、邻居图、标签和二维坐标不是同一种东西。
从 FASTQ 到表达矩阵,再到 PCA 和 neighbor graph,每一步都引入新的假设。聚类来自图结构,UMAP 只是图结构的二维表示。
Part I · 从细胞到计数
先理解液滴、条形码、UMI 与 cell calling,知道矩阵中的一列为什么可以被称为一个细胞。
Bulk 平均值丢掉了什么
QUESTION组织平均表达升高,是每种细胞都升高,还是某类细胞变多或只在特定细胞中激活?
INTUITION · 先建立直觉
类比一锅汤的平均咸度:同样的平均值,可能来自每勺都更咸,也可能只是咸味配料变多。类比只帮助建立直觉,不是科研证据。
CLINICAL CASE · 肺纤维化情境
肺纤维化组织中 COL1A1 总体升高。我们需要区分成纤维细胞比例增加、单细胞表达增强,或两者同时发生。
WHY / PRINCIPLE
Bulk 测量混合样本的平均表达,scRNA-seq 同时保留细胞异质性与样本来源,但单细胞观察数不能替代患者数。
WORKFLOW · 数据怎样变化
- 01定义临床问题与独立样本
- 02获得每细胞表达谱
- 03先识别细胞身份
- 04回到 donor 层比较状态与组成
所有细胞的信号被混合
“这一块组织发生了变化。”
每个细胞有独立表达谱
“究竟是哪一类细胞发生了变化?”
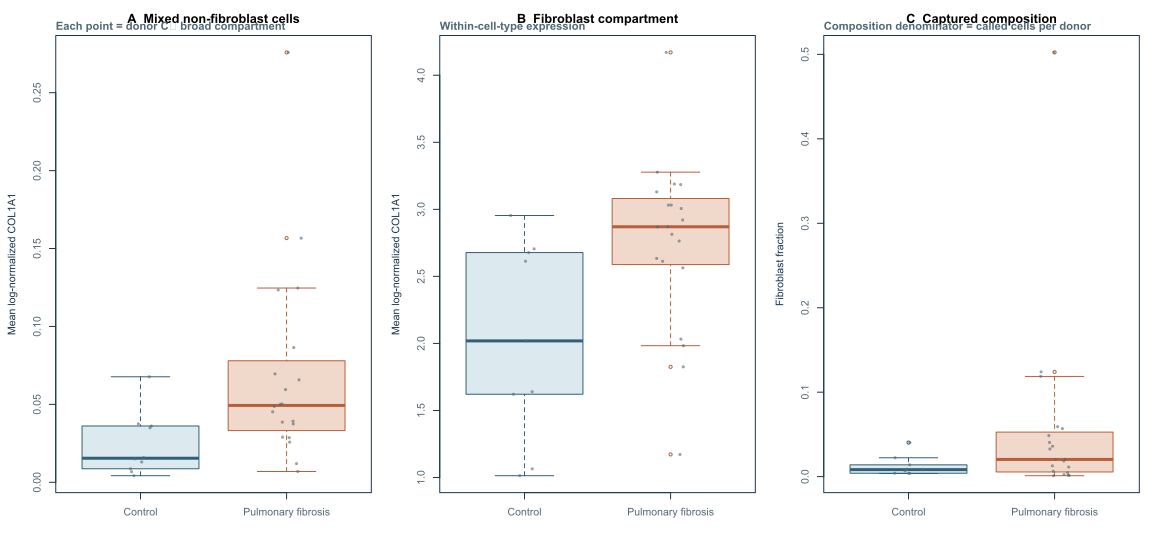
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · scripts/figures/scrna/generate-gse135893-foundations.R
- HASH
1aaf3c7d9901…
逐项核对数值、适用条件与下一步
01先确认点代表细胞而非患者通过快速筛查
观察单位与独立重复数
同时报告图中细胞数与疾病比较中的独立 donor 数;两者不能互换。
- 分子
- 纳入分析的唯一 donor
- 分母
- 设计中满足纳入条件的 donor
- 统计单位
- donor(疾病比较);cell(描述性定位)
- 单位
- donors
GSE135893 IPF/control metadata
疾病比较的统计重复
- PASS明确写出 cells nested within 30 donors,并以 donor 而非 cell 计算疾病效应
- REVIEW只有细胞数或只在图注模糊提到样本
- STOP把 114,396 个细胞当作 114,396 个独立患者观察
适用范围:适用于本课程的 GSE135893 疾病比较;其他研究必须换成自己的独立生物重复。
联合因素:donor · condition · cell nesting
独立样本数 = unique(donor),不是矩阵列数114,396 列细胞表达只能提供细胞内精度;疾病比较仍为 30 位 donor。
本图把细胞用于定位表达,把 donor 明确为疾病比较单位,因此没有发生 cells-as-replicates。
02比较 Bulk 平均值与细胞类型分层表达需要情境化复核
COL1A1 细胞内表达分层
在成纤维细胞和非成纤维细胞中分别按 donor 汇总 log-normalized COL1A1。
- 分子
- 该 donor、该 compartment 的 COL1A1 归一化表达总和
- 分母
- 该 donor、该 compartment 的纳入细胞数
- 统计单位
- donor × broad compartment
- 单位
- mean log-normalized expression
真实矩阵与原作者 cell type 标签
gene-level raw counts → counts/10k → log1p
- PASS疾病方向在多个 donor 的成纤维细胞汇总中可见,并与非成纤维 compartment 分开
- REVIEW组均值不同,但组内 donor 高度重叠或某个 donor 极端
- STOP只比较所有细胞合并均值,无法定位差异来自哪类细胞
适用范围:探索性公开数据派生图;未调整年龄、性别、取材和技术协变量。
联合因素:cell type · donor · library size
每细胞 log1p(count/total UMI×10,000),再在 donor×compartment 内取均值图 A 与 B 必须一起读:非成纤维与成纤维 compartment 的纵轴范围不同,不能只比较箱体高度。
图能定位 COL1A1 主要差异层,但尚未给出预设 donor-level 回归、CI 与协变量敏感性。
03按 donor 着色检查重复需要情境化复核
donor 覆盖与单样本驱动
检查每组 donor 点的数量、离散程度和极端点,而不是只读箱线图中位数。
- 分子
- 删除后仍保持预设方向的重算次数
- 分母
- 可计算效应的 donor 删除次数
- 统计单位
- donor
- 单位
- leave-one-donor-out runs
10 control + 20 pulmonary fibrosis
至少捕获一个相关注释细胞
- PASS两组均有多个 donor,去掉任一 donor 后方向不反转且效应变化 <20%
- REVIEWleave-one-donor-out 后效应变化 20–35%
- STOP去掉一个 donor 后方向反转,或某组有效 donor <3
适用范围:20%/35% 是本课敏感性分层,不是通用统计阈值;正式研究预注册判据。
联合因素:每组 donor 数 · 极端值 · 组内异质性
对每个 donor 依次删除并重算效应;记录最大相对变化与是否反号29 个可计算 donor 不等于 29 个同方向 donor;必须真正输出每次删除后的效应。
当前 Figure 显示 donor 点,但尚未把 leave-one-donor-out 数值画出,因此只能进入复核。
04区分组成变化与细胞内表达变化需要情境化复核
表达变化与组成变化双分解
同一候选基因必须并列报告细胞类型内表达和该细胞类型在每位 donor 中的捕获比例。
- 分子
- 指定细胞类型的 called cells
- 分母
- 该 donor 的全部纳入 called cells
- 统计单位
- donor
- 单位
- proportion
within-fibroblast COL1A1
fibroblast / all called cells per donor
- PASS两层分别给出分母、效应与不确定性,再说明哪一层贡献更大
- REVIEW30 donor 的两层方向一致,但未报告每 mm² 组织细胞密度、流式绝对计数,也未在 3 组相邻过滤规则下重算比例
- STOP用比例变化替代细胞内表达,或用表达升高声称细胞数量增加
适用范围:Panel C 是捕获组成,不是组织绝对丰度。
联合因素:细胞内表达 · 捕获比例 · 解离/过滤分母
总组织信号变化 ≈ 组成变化 + 细胞类型内表达变化 + 交互项Panel B 升高与 Panel C 升高可同时发生;二者都不能单独解释组织总量。
当前图完成了两层分解,但缺少组织学或流式绝对数量,组成解释仍有限。
05最后声明证据边界通过快速筛查
结论层级审计
把 Figure 能支持的定位性关联,与机制或因果主张逐项分开。
- 分子
- 已满足的证据层级
- 分母
- 拟主张结论所要求的证据层级
- 统计单位
- claim
- 单位
- evidence tier
横断面单细胞公开数据
本 Figure 未包含 perturbation/rescue
- PASS结论写成‘COL1A1 相关信号定位于候选细胞 compartment’
- REVIEW写成‘可能参与’,但同时给出验证计划
- STOP写成‘导致肺纤维化’或‘治疗该细胞即可逆转疾病’
适用范围:证据边界适用于本章所有横断面表达与组成结果。
联合因素:研究设计 · 统计单位 · 正交验证 · 干预
claim tier = min(设计层级, 统计层级, 验证层级)没有扰动与 rescue 时,最强结论停在关联和定位假设。
将 Association、Mechanism、Causality 明确拆开,避免单图升级结论。
先锁定 探索图中的点是细胞;疾病比较的独立重复是 donor,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
只有合并后的细胞图、没有 donor 信息,或结论完全由单个样本驱动时必须停止疾病推断。
回到 患者肺组织、供体与疾病状态元数据 定位冲突来自哪个独立单位,并用 Seurat/Scanpy 分层概览 的诊断输出复算;冲突未解释前只保留描述性结果。
支持定位疾病相关表达主要出现在哪些细胞类型,并形成后续验证假设。
不能仅凭细胞级表达证明某细胞或基因导致肺纤维化。
VALIDATION · 下一层证据
- 留出至少一个 探索图中的点是细胞;疾病比较的独立重复是 donor 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R 分析调用片段
此片段承接本章数据对象;运行前先完成输入准备,不能作为独立脚本直接执行。
调用片段 · 需先准备下方输入对象
library(Matrix)
counts <- readMM(gzfile("GSE135893_matrix.mtx.gz"))
meta <- read.csv(gzfile("GSE135893_IPF_metadata.csv.gz"), check.names = FALSE)
# 图中的细胞用于定位;疾病比较必须回到 donor × cell type
pseudobulk <- rowsum(t(counts[, match(meta[[1]], barcodes)]), interaction(meta$Sample_Name, meta$celltype))Python 分析调用片段
此片段承接本章数据对象;运行前先完成输入准备,不能作为独立脚本直接执行。
调用片段 · 需先准备下方输入对象
import scanpy as sc
adata = sc.read_mtx("GSE135893_matrix.mtx.gz").T
adata.obs = metadata.set_index("cell_id").loc[adata.obs_names]
# display by cell; test disease effects at donor level
donor_celltype = adata.obs.groupby(["Sample_Name", "celltype"]).size()TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持定位疾病相关表达主要出现在哪些细胞类型,并形成后续验证假设。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 探索图中的点是细胞;疾病比较的独立重复是 donor 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 Seurat/Scanpy 分层概览 误差来源的测量,最能区分技术解释与生物解释?
Droplet、Cell Barcode 与 UMI
QUESTION一条测序 read 如何被追溯到某个液滴、某个细胞和某个原始 RNA 分子?
INTUITION · 先建立直觉
像给每个快递箱贴地址码、给箱内每件物品贴流水号;地址码对应液滴来源,UMI 用于识别扩增前的分子。类比不是测序证据。
CLINICAL CASE · 肺纤维化情境
解离后的肺组织含上皮、免疫和基质细胞;液滴系统必须在混合悬液中保留每个转录本的细胞来源。
WHY / PRINCIPLE
Cell barcode 标记液滴来源,UMI 合并 PCR duplicates;捕获失败、barcode collision 与 ambient RNA 仍然存在。
WORKFLOW · 数据怎样变化
- 01限制稀释形成液滴
- 02同一液滴添加 cell barcode
- 03每个分子添加 UMI
- 04扩增测序后按 barcode/UMI 去卷积
UMI:从 duplicate reads 回到原始分子计数
4 个最初被捕获的 RNA 分子;我们关心的计数从它们开始,而不是从测序仪输出开始。
先观察 4 个被捕获的 RNA 分子如何获得不同 UMI,再看 PCR 将每个模板复制成多条 reads,最后按 cell barcode、gene 与 UMI 的组合折叠候选技术重复。
原创教学交互 · 模拟数据 · 未复制论文 Figure解释 UMI 为什么能帮助识别同一捕获分子的 PCR copies,并说明 reads 计数与 UMI-collapsed count 的区别。
不能证明 UMI count 等于样本中的绝对 RNA 分子数;未捕获分子、UMI collision、测序错误与饱和仍会造成偏差。
PCR:为什么 reads 会指数增加,原始分子却没有增加
输入:1 个分子的模板,尚未扩增。 各泳道是不同时间的快照,不应把所有泳道相加;PCR copies 也不等于已测得的 reads。
这是理想化的倍增示意。真实 PCR 会受到扩增效率、饱和与序列偏好和随机性影响,并不保证每轮精确翻倍。
阶段 1 / 6:第 0 轮。 还没开始扩增:1 个原始 RNA 分子,1 条可观察的 copy。
理想化展示一个模板经过多轮 PCR 后形成 1→2→4→8→16→32 条 copies,并把 reads/copies 计数与原始 RNA 分子计数并列,突出两者的分叉。
原创教学交互 · 模拟数据 · 未复制论文 Figure解释 PCR amplification 如何从同一模板产生大量 reads,以及为何重复 reads 不能当作独立原始分子。
不能证明真实 PCR 每轮精确翻倍,也不能由 reads 数单独推出绝对表达量;扩增效率、饱和与序列偏好需要额外 QC。
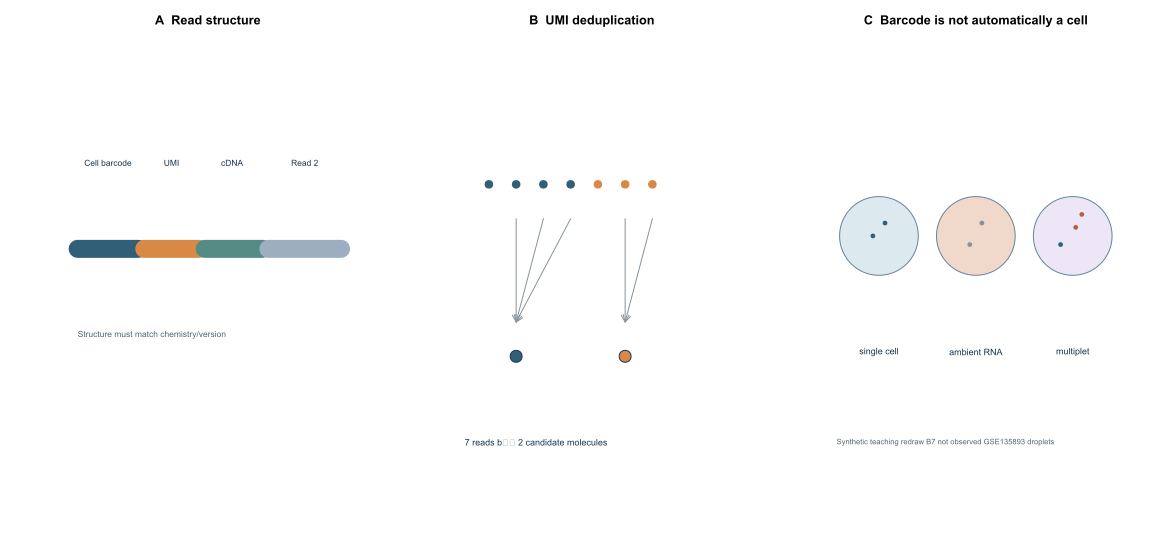
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R 4.5.3 · scripts/figures/scrna/generate-gse135893-foundations.R
- HASH
1290cbb92ed2…
逐项核对数值、适用条件与下一步
01确认 read 结构与 barcode whitelist通过快速筛查
Valid barcode rate
reads whose cell-barcode sequence matches the assay whitelist after the permitted correction
- 分子
- valid-barcode reads
- 分母
- all sequenced reads with a parsed barcode
- 统计单位
- read
- 单位
- %
教学模拟的 10x 3′ gene-expression library
- PASS≥85%: pass the initial library-structure screen
- REVIEW75–<85%: review read structure, chemistry and base quality
- STOP<75%: stop downstream aggregation until library structure is reconciled
适用范围:10x gene-expression chemistry quick screen; confirm the exact chemistry and Cell Ranger version rather than transferring it to other assays
联合因素:chemistry version · read structure · barcode correction policy
valid-barcode reads ÷ all parsed reads × 100205.2M ÷ 225.0M = 91.2%; this passes the library-structure screen, but does not prove that each barcode is a cell
91.2% exceeds the applicable 85% quick screen and the R1 structure matches the configured chemistry, so barcode parsing can proceed.
02看有效 barcode/UMI 比例需要情境化复核
Reads in cells
fraction of confidently mapped transcriptomic reads assigned to called-cell barcodes
- 分子
- mapped reads in called cells
- 分母
- all confidently mapped transcriptomic reads
- 统计单位
- library and sample
- 单位
- %
teaching library
8 teaching samples
- PASS≥70% and no sample <60%: pass the teaching screen
- REVIEW50–<70% or one sample <60%: review ambient RNA and cell calling
- STOP<50%: stop interpretation and reconcile suspension quality, ambient profile and cell calling
适用范围:Worked example for this lesson only; derive a study rule from assay, tissue and sample-level distributions
联合因素:tissue dissociation · ambient RNA · cell-calling boundary · sample-specific distribution
reads assigned to called cells ÷ confidently mapped transcriptomic reads × 100, calculated per sample firstPooled 74.6% passes, but S3=61.8% remains under review; a pooled value must not hide the weak sample
The pooled fraction is above 70%, but the lowest sample is only 1.8 percentage points above the review boundary; the outcome is review rather than automatic pass.
03检查每液滴 UMI 与基因数分布需要情境化复核
Median genes and UMI per called cell
sample-wise median complexity plus a robust lower-tail boundary
- 统计单位
- called cell, summarized per sample and cell type
- 单位
- genes / UMI
teaching sample S3
teaching sample S3
median − 3 × MAD within epithelial cells
- PASScell-type median above its median−3×MAD boundary and no disconnected low-complexity mode
- REVIEW1–5% of a cell type below the boundary: inspect jointly with percent.mt and ambient markers
- STOP>5% below the boundary or a separate low-complexity mode: stop naming that mode as a new cell type
适用范围:Robust boundary is recomputed within each sample and broad cell class; 620 is not a universal nFeature threshold
联合因素:cell type RNA content · sequencing depth · sample median · MAD
lower boundary = within-group median − 3 × median absolute deviationEpithelial median=1,840 and MAD=407, so the teaching lower boundary is 619; cells below it require joint QC review
The median itself is not the decision. The separate lower-complexity mode and its overlap with mitochondrial/ambient signals determine whether the tail is technical.
04识别高计数 doublet 与低计数空液滴暂停解释
Multiplet evidence
difference between loading-model expectation and cells flagged by an algorithm plus mutually exclusive lineage markers
- 分子
- flagged called cells
- 分母
- all called cells
- 统计单位
- sample and called cell
- 单位
- %
9,200 loaded cells; teaching chemistry
teaching sample S3
called cells
- PASSalgorithm estimate within ±2 percentage points of loading expectation and no lineage-conflict enrichment
- REVIEWdifference >2–4 points: review homotypic/heterotypic calls
- STOPdifference >4 points plus enriched mutually exclusive markers: stop subcluster interpretation until multiplets are handled
适用范围:The expected rate depends on platform loading and recovery; algorithm scores are not ground truth
联合因素:loaded-cell number · recovered cells · homotypic rate · marker conflict
algorithm estimate − loading expectation; then stratify marker conflicts by sample9.1% − 5.4% = +3.7 points and lineage conflicts are enriched, so S3 enters manual/algorithmic doublet review
A +3.7-point excess is not enough alone, but its agreement with mutually exclusive lineage markers makes the technical explanation credible.
05回查实验装载浓度通过快速筛查
Recovery and loading consistency
relationship among target recovery, called cells, empty droplets and estimated multiplets
- 分子
- called cells
- 分母
- target recovered cells
- 统计单位
- sample/library
- 单位
- %
teaching sample S3
teaching sample S3
teaching sample S3
- PASScalled cells within 80–120% of target and no conflicting ambient/doublet evidence
- REVIEW60–<80% or >120–140%: review viability, counting and cell calling
- STOP<60% or >140% with ambient/doublet signals: stop and reconcile loading records
适用范围:Operational teaching band; replace it with platform run design and laboratory acceptance criteria
联合因素:target recovery · cell concentration · viability · called-cell algorithm
called cells ÷ target recovered cells × 1006,420 ÷ 6,000 = 107%; recovery alone passes, but the doublet check remains under review
107% is inside the teaching band, yet recovery cannot override the doublet evidence from the preceding check.
先锁定 UMI 近似原始分子事件,cell barcode 近似液滴而非自动等同于真实细胞,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
R1 长度或 barcode/UMI 区段与 chemistry sheet 不符、valid barcode <75%,或算法 doublet 率比装载预期高 >4 个百分点且伴互斥 marker 时暂停。
回到 单细胞悬液、带 barcode/UMI 的微珠与油相 定位冲突来自哪个独立单位,并用 10x 3′ chemistry 的诊断输出复算;冲突未解释前只保留描述性结果。
支持把 reads 汇总成候选细胞×基因计数。
不能仅凭 barcode 证明液滴只含一个完整且健康的细胞。
VALIDATION · 下一层证据
- 留出至少一个 UMI 近似原始分子事件,cell barcode 近似液滴而非自动等同于真实细胞 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R 分析调用片段
此片段承接本章数据对象;运行前先完成输入准备,不能作为独立脚本直接执行。
调用片段 · 需先准备下方输入对象
# 先从所用 chemistry sheet 记录 read 结构;不要从表达矩阵反推。
read_structure <- data.frame(segment=c("cell barcode","UMI","cDNA"), read=c("R1","R1","R2"), bases=c("chemistry-specific","chemistry-specific","remaining"))
stopifnot(all(read_structure$read %in% c("R1", "R2")))
# UMI 去重后的 count 是分子代理,不是 read 数。Python 分析调用片段
此片段承接本章数据对象;运行前先完成输入准备,不能作为独立脚本直接执行。
调用片段 · 需先准备下方输入对象
# Pseudocode: parsing depends on the exact 10x chemistry/version
segments = parse_read_structure(r1, r2, chemistry=chemistry)
molecules = deduplicate_by_umi(segments, keys=["cell_barcode", "gene", "umi"])
assert molecules.shape[0] <= segments.shape[0]TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持把 reads 汇总成候选细胞×基因计数。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 UMI 近似原始分子事件,cell barcode 近似液滴而非自动等同于真实细胞 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 10x 3′ chemistry 误差来源的测量,最能区分技术解释与生物解释?
为什么 barcode 不等于 cell
QUESTION哪些 barcode 来自真实细胞,哪些只是空液滴中的环境 RNA?
INTUITION · 先建立直觉
像在体育场检票:扫描到票号不代表观众已经入场,还要结合通过闸机的信号强度与人群分布。类比不是判定标准。
CLINICAL CASE · 肺纤维化情境
纤维化肺含高 RNA 细胞碎片与黏液,固定 UMI 排名阈值可能把空液滴误当细胞,或丢掉低 RNA 免疫细胞。
WHY / PRINCIPLE
Cell calling 结合 barcode 总 UMI 排名、背景表达和统计模型;拐点不是跨组织固定阈值。
WORKFLOW · 数据怎样变化
- 01绘制 barcode-rank 曲线
- 02估计 ambient RNA 背景
- 03识别 knee/inflection 与低 RNA 候选
- 04联合 marker、样本和后续 QC 复核
Cell Calling:从 barcode rank 到可复核的保留决策
只按排序位置切断;用于说明 knee 不能单独定义 cell。 不是只认拐点:柱长为 log10(UMI);勾号 / 横线显示保留状态。当前 seed 中位数 m=1310,m/10=131 UMI。阈值只服务于这份公开模拟数据,不是推荐参数。
保留 7 个;相对模拟真值:误留 0,漏掉 2。FDR:不可用,未运行统计检验。数量变化需要回到具体条码与背景证据复核。
下一步:真实分析使用完整 raw droplets,按 DropletUtils 文档建立背景模型并检查结果;不能给本示意套上 EmptyDrops 的 FDR 标签。
核对所有模拟条码、组成与真值
背景:模拟基因 A 占 10%,B 占 90%;规则差值阈值为 30 个百分点。每个条码 B 的比例 = 1−A。真值是人为设定,只用于检查错误计数。
| 条码 | UMI | 模拟 A 占比 | 设定真值 | 当前判定 |
|---|---|---|---|---|
| B1 | 1820 | 80% | 细胞 | 保留 |
| B2 | 1650 | 70% | 细胞 | 保留 |
| B3 | 1480 | 75% | 细胞 | 保留 |
| B4 | 1310 | 65% | 细胞 | 保留 |
| B5 | 1150 | 70% | 细胞 | 保留 |
| B6 | 980 | 60% | 细胞 | 保留 |
| B7 | 760 | 70% | 细胞 | 保留 |
| B8 | 480 | 15% | 空滴 | 未保留 |
| B9 | 220 | 65% | 细胞 | 未保留 |
| B10 | 120 | 62% | 空滴 | 未保留 |
| B11 | 90 | 60% | 细胞 | 未保留 |
| B12 | 70 | 12% | 空滴 | 未保留 |
| B13 | 55 | 20% | 空滴 | 未保留 |
| B14 | 45 | 10% | 空滴 | 未保留 |
| B15 | 38 | 15% | 空滴 | 未保留 |
| B16 | 32 | 10% | 空滴 | 未保留 |
| B17 | 27 | 20% | 空滴 | 未保留 |
| B18 | 23 | 10% | 空滴 | 未保留 |
| B19 | 19 | 12% | 空滴 | 未保留 |
| B20 | 16 | 10% | 空滴 | 未保留 |
20 个 barcode 的计数、两基因组成和细胞真值均为手工设定。切换透明规则,观察具体保留哪些条码以及与已知模拟真值的差异;不是 R 数据摘要,也未运行 OrdMag / EmptyDrops。
原创教学交互 · 模拟数据 · 未复制论文 Figure当前 Rank-only、k=7:候选 7 / 20,未保留 13;假阳性 0、假阴性 2 均按逐条模拟真值计算,而非估出来的概率。
不能由这 20 个模拟 barcode 证明真实 cell count;这里没有 FDR。真实 cell calling 需要完整 raw droplets 与适当背景模型,且不能据此排除 doublet 或受损细胞。
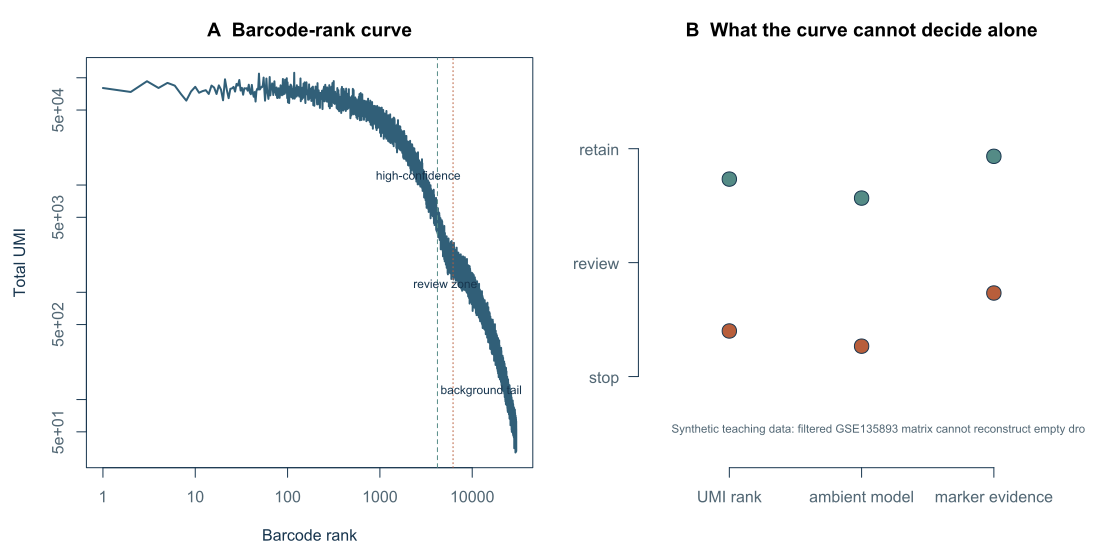
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R 4.5.3 · scripts/figures/scrna/generate-gse135893-foundations.R
- HASH
fa5f98cf4e78…
逐项核对数值、适用条件与下一步
01横轴按 barcode UMI 排名需要情境化复核
Barcode rank 与 total UMI
把所有 barcode 按 total UMI 降序,并在双对数坐标读取高计数平台、过渡区与背景尾部。
- 分子
- 该 barcode 的 UMI
- 分母
- 无;排序统计
- 统计单位
- barcode/droplet
- 单位
- total UMI
R 固定种子教学模拟
不是 GSE135893 实测 knee
- PASS曲线显示可解释的平台—过渡—背景三段,并保留全 barcode 矩阵
- REVIEWknee/inflection 相距较大,需要统计背景模型
- STOP仅凭一个手画拐点删除过渡区
适用范围:用于理解读图;GSE135893 processed matrix 不是 raw droplets,不能据此重建真实 cell calling。
联合因素:rank · total UMI · 预期回收数
rank = order(total UMI, decreasing=TRUE)模拟中 rank 4,200–6,200 是待复核区,不是自动删除区。
曲线只确定检查顺序,不能给 GSE135893 生成真实 empty-droplet 概率。
02纵轴读总 UMI 的对数尺度需要情境化复核
Knee–inflection 不确定区宽度
用两个候选边界之间的 barcode 数量表示只靠曲线无法判定的区域。
- 分子
- review-zone barcodes
- 分母
- all simulated barcodes
- 统计单位
- barcode/droplet
- 单位
- %
rank 4,200–6,200
2,000 / 30,000
- PASS过渡区继续进入背景模型和 marker 复核
- REVIEW过渡区占比高且随样本差异大
- STOP把 inflection 以下全部称为空液滴
适用范围:6.67% 来自本教学模拟,不可迁移为平台阈值。
联合因素:曲线形状 · 样本 · 预期细胞数
(6,200−4,200)/30,000×100 = 6.67%2,000 个 barcode 的身份需要额外证据;曲线本身没有 cell 标签。
存在明确过渡区,因此必须使用背景概率与生物 marker 联合判断。
03先找平台与陡降而非单一数值暂停解释
背景 profile 区分度
比较候选 barcode 与空液滴背景 RNA profile 的偏离,而非只比较总 UMI。
- 统计单位
- barcode/droplet
- 单位
- availability
processed GSE135893 inputs lack raw droplets
raw matrix needed
- PASS使用每个样本的空液滴估计背景,并报告 Monte Carlo/FDR 规则
- REVIEW背景库过小或高丰度环境基因支配 profile
- STOP没有 raw droplets 却声称已校正 ambient background
适用范围:这是输入充分性检查,没有数据时答案必须是 unavailable。
联合因素:raw droplets · ambient profile · FDR
P(cell) 不能由 filtered matrix 反推本地只有 processed matrix,所以本章不伪造 GSE135893 emptyDrops 结果。
缺少 raw droplets 是结构性缺失,不可用更漂亮的 barcode-rank 模拟替代。
04复核低 RNA 真实群与背景基因需要情境化复核
低 RNA 群的成套 marker
检查低 UMI 候选是否表达同一谱系的多个正 marker,并缺乏高丰度 ambient-only 模式。
- 统计单位
- barcode summarized across sample
- 单位
- marker set evidence
教学 barcode-rank 不含 gene profile
教学复核规则
- PASS多个一致 marker、负 marker 与跨样本复现共同支持低 RNA 真实群
- REVIEW只有单 marker 或仅一个样本出现
- STOP只表达 MALAT1、线粒体或组织高丰度环境基因
适用范围:marker 数不是自动规则;需要结合组织知识、表达比例和 donor 分布。
联合因素:正 marker · 负 marker · ambient genes · sample recurrence
按候选群计算 pct.in、pct.background 与 donor recurrence单个 CD3D read 不足以保留 barcode;CD3D/CD247/TRBC1 成套且多样本出现才增强证据。
当前模拟没有 gene profile,所以不能完成低 RNA 真实细胞判定。
05比较每个样本的曲线暂停解释
逐样本 cell-calling 一致性
每个样本分别报告 called cells、目标回收、reads-in-cells 与 review-zone 数量。
- 统计单位
- sample/library
- 单位
- libraries
不代表 30 位 GSE135893 donor 的原始文库
当前缓存未包含 raw droplets
- PASS逐样本曲线与实验装载记录可以一一对应
- REVIEW某样本 review zone 或背景比例偏离其余样本
- STOP把合并曲线用于所有样本的统一阈值
适用范围:本课程必须显示缺失数据,不用 pooled simulation 假装样本复现。
联合因素:sample · loading target · called cells · ambient RNA
每样本独立统计后再汇总;禁止先合并 barcode当前只能完成方法教学,不能给 GSE135893 报告真实 called-cell acceptance。
没有逐样本 raw droplet 对象,cell-calling 的真实验收链不完整。
先锁定 barcode/droplet,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
仅用统一 nCount 阈值,或低计数 barcode 只表达高丰度环境基因时停止保留判断。
回到 all-barcode UMI count matrix 定位冲突来自哪个独立单位,并用 Cell Ranger cell calling 的诊断输出复算;冲突未解释前只保留描述性结果。
支持区分高概率细胞液滴与空液滴。
不能单独排除 doublet、受损细胞或 ambient RNA 污染。
VALIDATION · 下一层证据
- 留出至少一个 barcode/droplet 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R 分析调用片段
此片段承接本章数据对象;运行前先完成输入准备,不能作为独立脚本直接执行。
调用片段 · 需先准备下方输入对象
library(DropletUtils)
raw <- DropletUtils::read10xCounts("raw_feature_bc_matrix")
called <- emptyDrops(counts(raw))
# FDR 是背景模型证据;还要联合 barcode-rank、marker 与样本级 QC。
retain <- !is.na(called$FDR) & called$FDR <= 0.001Python 分析调用片段
此片段承接本章数据对象;运行前先完成输入准备,不能作为独立脚本直接执行。
调用片段 · 需先准备下方输入对象
import scanpy as sc
raw = sc.read_10x_mtx("raw_feature_bc_matrix")
sc.pp.calculate_qc_metrics(raw, inplace=True)
# Use an explicit empty-droplet model; a fixed total-count cut is not cell calling.
barcode_rank = raw.obs["total_counts"].sort_values(ascending=False)TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持区分高概率细胞液滴与空液滴。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 barcode/droplet 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 Cell Ranger cell calling 误差来源的测量,最能区分技术解释与生物解释?
Part II · 从原始矩阵到细胞关系
把原始计数经过 QC、标准化、HVG、PCA、邻居图与批次判断,变成可审查的细胞关系。
哪些细胞值得留下
QUESTION怎样判断一个细胞的表达谱仍足以代表生物学,而不是受损、空液滴或 doublet?
INTUITION · 先建立直觉
像临床化验先判断样本是否溶血:不是看到一个异常值就丢弃,而要联合多个指标、样本背景和分布形状。类比不是 QC 阈值。
CLINICAL CASE · 肺纤维化情境
GSE135893 肺样本中 nFeature、nCount 与 percent.mt 呈连续且供体特异的分布;硬切线会对不同细胞类型产生不等损失。
WHY / PRINCIPLE
QC 是多指标决策:复杂度、线粒体比例、doublet、ambient RNA 与样本背景应联合判断,固定阈值不是通用标准。
WORKFLOW · 数据怎样变化
- 01逐样本画分布
- 02联合 nCount/nFeature/percent.mt
- 03评估 ambient RNA 与 doublet
- 04检查过滤前后细胞类型和 donor 损失
阈值不是固定标准。先看数据分布、组织特性、测序深度、样本重复和研究问题。
Ambient RNA:游离 RNA 如何污染一个细胞的表达谱
深绿:细胞自身;赭色:背景污染。 柱高用同一 0–600 刻度;下方逐基因表提供不依赖颜色的数值。
阶段 1 / 4:污染前参照。 先定义一个没有污染、总量为 1000 的合成参照。五个模拟基因不是实际 marker;这些数值由下方已知组成指定。
细胞贡献 = (1−ρ) × 1000 × 细胞组成;污染贡献 = ρ × 1000 × 背景组成;混合 = 两者相加。校正示意 = max(0, 混合 − ρ̂ × 1000 × 背景组成)。
核对模型组成与逐基因输入 / 输出
| 模拟基因 | 细胞 / 背景组成 | 自身 + 污染 | 混合 | 当前输出 |
|---|---|---|---|---|
| 模拟 A | 50% / 10% | 400 + 20 | 420 | 500 |
| 模拟 B | 30% / 10% | 240 + 20 | 260 | 300 |
| 模拟 C | 15% / 10% | 120 + 20 | 140 | 150 |
| 模拟 D | 5% / 30% | 40 + 60 | 100 | 50 |
| 模拟 E | 0% / 40% | 0 + 80 | 80 | 0 |
方法背景:SoupX(Young & Behjati, 2020)。本文演示的是混合与估计误差,不是复现其推断算法。
以总量 1000 个期望 UMI 和五个模拟基因,展示污染前参照、背景贡献、混合观测与假设校正。所有数字都能由下方组成与公式复算;未使用患者数据、真实 marker 值或算法输出。
原创教学交互 · 模拟数据 · 未复制论文 Figure解释固定总量下的污染混合,以及污染比例估计偏差如何造成残留或误减。可比较图中分段、逐基因数字与总量是否一致。
不能从这个合成模型估计真实样本的污染比例、判断细胞身份或证明校正已恢复真值;实际方法还依赖背景估计、细胞信息与诊断检查。
Doublet:一个观测里的两个细胞
微流控希望把细胞分隔进液滴,但一个 barcode 不保证对应一个细胞;这里先从单细胞液滴的示意开始。
跟随一个合成液滴:两个细胞被同一 barcode 标记,产生混合谱。图中两群之间的位置只是一种可能示意,不能据此定位所有 doublet。
原创教学交互 · 模拟数据 · 未复制论文 Figure解释 doublet 如何产生混合表达谱,以及为什么位于两个 cluster 之间、marker 冲突的观测需要怀疑技术来源。
不能凭位置或单一 marker 断定某个 cluster 全是 doublet;确认需要 doublet 评分、样本重复与生物学合理性共同支持。
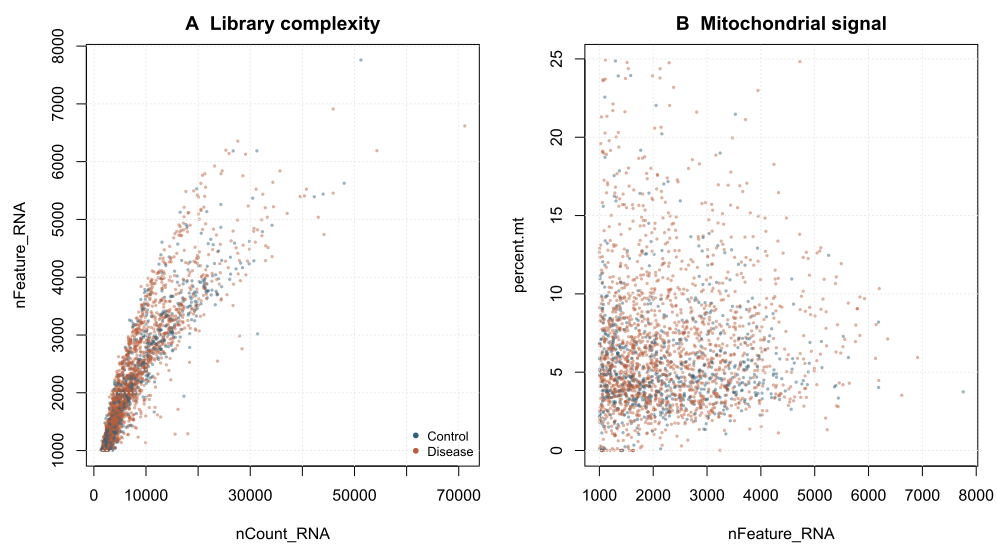
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · scripts/figures/scrna/generate-gse135893-metadata.R
- HASH
150f475f4abb…
逐项核对数值、适用条件与下一步
01坐标先确认单位和对数变换需要情境化复核
nCount_RNA 分布(每细胞 UMI)
先按 donor 和 broad cell type 查看 total UMI 的中位数、MAD 与尾部;不用跨组织固定阈值。
- 统计单位
- cell, summarized within donor and broad cell type
- 单位
- UMI/cell
114,396 GSE135893 metadata cells
候选高计数/doublet 尾部
- PASS尾部在多个 donor 中有连续分布,并与预期高 RNA cell type 对应
- REVIEW某 donor 的中位数或尾部明显偏离其他 donor
- STOP高计数群同时出现互斥谱系 marker 或由单样本形成独立簇
适用范围:分位数描述当前数据,不是保留/删除阈值。
联合因素:donor · cell type · doublet score
逐 donor×broad type 计算 median 与 MAD;标记而非立即删除尾部总体 median=6,435 UMI 不能用于所有细胞类型;巨噬细胞与淋巴细胞的 RNA 含量不同。
全局分布只能定位尾部,正式判断必须回到 donor 与细胞类型。
02按 donor 分面而非只看合并图需要情境化复核
nFeature_RNA 分布(检测基因数)
读取每细胞非零基因数的分位数,并判断低复杂度尾部是否形成独立模式。
- 统计单位
- cell within donor and broad cell type
- 单位
- genes/cell
114,396 cells
在 donor×broad type 内重算
- PASS低尾部与主分布连续,且保留已知低 RNA 谱系
- REVIEW1–5% 同类细胞低于组内 robust boundary
- STOP>5% 形成独立低复杂度模式并伴高 mt/ambient profile
适用范围:1,170 是全局 P10,不是 nFeature cutoff。
联合因素:donor · broad cell type · sequencing depth
lower = within-group median − 3×MAD(必要时在 log10 尺度)直接用 nFeature>1,170 会机械删除真实低 RNA 细胞,也可能保留某些损伤细胞。
需要组内 robust boundary 与多指标一致性,而不是全局 P10。
03看指标之间的连续关系需要情境化复核
percent.mt 分布
线粒体 UMI 占 total UMI 的比例;必须联合复杂度、组织背景和样本分布。
- 分子
- mitochondrial-gene UMI
- 分母
- all UMI in the cell
- 统计单位
- cell, audited per donor and broad cell type
- 单位
- %
114,396 cells
需要按 donor/cell type 量化
- PASS高 mt 仅为连续尾部且不形成低复杂度/应激群
- REVIEW某 donor 或细胞类型的分布整体右移,需要检查组织与解离
- STOP高 mt、低 nFeature、应激/ambient 信号共同形成独立簇
适用范围:20% 只是图中尾部定位值,不是肺组织通用删除线。
联合因素:nFeature · nCount · donor · cell type
100 × mitochondrial UMI / total UMI,逐样本报告percent.mt=15% 的细胞若复杂度高且属于特定谱系,不能仅凭该值删除。
单指标没有足够特异性;需要与复杂度和样本分布联合。
04定位尾部、断层和异常簇需要情境化复核
疑似 doublet 的联合证据
把高 nCount/nFeature、算法分数和互斥谱系 marker 作为三条不同来源的证据。
- 统计单位
- sample and called cell
- 单位
- % flagged cells
必须另行计算
不是 ground truth
- PASS算法估计接近装载预期,且无互斥 marker 富集
- REVIEW算法与装载预期相差 2–4 个百分点或仅一类证据异常
- STOP差异 >4 个百分点且互斥 marker 同时富集
适用范围:2/4 个百分点为本课操作性分层;真实预期率随平台装载变化。
联合因素:loading expectation · algorithm score · marker conflict
algorithm doublet rate − platform/loading expectation,逐样本计算只有高 nCount 不能叫 doublet;巨噬细胞本身可能 RNA 含量高。
当前公开 metadata 没有独立 doublet score,因此不能宣称已排除 multiplet。
05比较过滤前后群体保留需要情境化复核
过滤影响审计
应用候选 QC 规则后,按 donor 与 broad cell type 报告删除比例及结构变化。
- 分子
- removed cells
- 分母
- pre-QC cells
- 统计单位
- donor × broad cell type
- 单位
- % removed
先诊断后过滤
retained/removed table
- PASS没有 donor 被大量清空,主要 cell type 在多 donor 中保留,核心结论对相邻规则稳健
- REVIEW某 donor/type 删除比例明显高于其余组
- STOP规则选择性清除一个真实群,或疾病效应随阈值反转
适用范围:停止规则以研究结论敏感性为核心,不设统一删除比例。
联合因素:donor retention · cell-type retention · effect sensitivity
removed / pre-QC cells,按 donor×type;并重算核心效应总体只删 5% 也可能把一个稀有群删掉;总体比例不是安全保证。
尚未展示过滤前后对照,因此不能把当前 QC 诊断当作完成验收。
先锁定 细胞用于诊断;阈值影响必须汇总到 donor 和 cell type,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
某 donor 被大比例清空、候选群只因 percent.mt 略高被删除,或阈值来自其他组织时必须暂停。
回到 called-cell matrix、每细胞 QC 指标、donor 与组织来源 定位冲突来自哪个独立单位,并用 miQC 的诊断输出复算;冲突未解释前只保留描述性结果。
支持降低明显低质量、空液滴和 doublet 对下游结构的影响。
不能保证留下的每个细胞都无技术偏差,也不能把过滤后的图视为机制证据。
VALIDATION · 下一层证据
- 留出至少一个 细胞用于诊断;阈值影响必须汇总到 donor 和 cell type 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
逐细胞计算三项 QC · R 可运行示例
先检查计数、检测基因数与线粒体占比的分母,再按 donor 查看分布。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 600 genes x 120 cells; not GSE135893
library(Seurat)
set.seed(104729)
counts <- matrix(rpois(600 * 120, lambda = rep(seq(0.2, 3, length.out = 600), 120)), nrow = 600)
for (k in 0:2) counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] <- counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] + 4L
counts[1:12, 1:6] <- counts[1:12, 1:6] + 20L
rownames(counts) <- c(paste0("MT-", 1:12), paste0("GENE", 13:600))
colnames(counts) <- paste0("cell", 1:120)
object <- CreateSeuratObject(counts = counts, min.cells = 0, min.features = 0)
object$donor <- rep(paste0("D", 1:4), length.out = 120)
stopifnot(all(dim(object) == c(600L, 120L)), all(colSums(counts) > 0))
object[["percent.mt"]] <- PercentageFeatureSet(object, pattern = "^MT-")
qc <- object[[]][, c("donor", "nCount_RNA", "nFeature_RNA", "percent.mt")]
print(head(qc))
print(aggregate(percent.mt ~ donor, qc, function(x) quantile(x, c(.1, .5, .9))))
expected_mt <- colSums(counts[1:12, ]) / colSums(counts) * 100
stopifnot(max(abs(qc$percent.mt - expected_mt)) < 1e-8)
print(sessionInfo())这些数值只能用于学习 QC 计算,不能据此选定真实组织的过滤阈值。
逐细胞计算三项 QC · Python 可运行示例
先检查计数、检测基因数与线粒体占比的分母,再按 donor 查看分布。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 120 cells x 600 genes; not GSE135893
import numpy as np
import scanpy as sc
from anndata import AnnData
from importlib.metadata import version
rng = np.random.default_rng(104729)
counts = rng.poisson(np.linspace(0.2, 3, 600), size=(120, 600))
for k in range(3):
counts[k*40:(k+1)*40, 20+k*40:60+k*40] += 4
counts[:6, :12] += 20
adata = AnnData(counts.astype(float))
adata.var_names = [f"MT-{i+1}" if i < 12 else f"GENE{i+1}" for i in range(600)]
adata.obs_names = [f"cell{i+1}" for i in range(120)]
adata.obs["donor"] = [f"D{i % 4 + 1}" for i in range(120)]
adata.layers["counts"] = adata.X.copy()
assert adata.shape == (120, 600) and np.all(counts.sum(axis=1) > 0)
adata.var["mt"] = adata.var_names.str.startswith("MT-")
sc.pp.calculate_qc_metrics(adata, qc_vars=["mt"], percent_top=None, log1p=False, inplace=True)
qc = adata.obs[["donor", "total_counts", "n_genes_by_counts", "pct_counts_mt"]]
print(qc.head())
print(qc.groupby("donor")["pct_counts_mt"].quantile([.1, .5, .9]))
expected_mt = counts[:, :12].sum(axis=1) / counts.sum(axis=1) * 100
assert np.allclose(qc["pct_counts_mt"], expected_mt, atol=1e-8)
print({p: version(p) for p in ("scanpy", "anndata", "numpy")})这些数值只能用于学习 QC 计算,不能据此选定真实组织的过滤阈值。
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持降低明显低质量、空液滴和 doublet 对下游结构的影响。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 细胞用于诊断;阈值影响必须汇总到 donor 和 cell type 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 miQC 误差来源的测量,最能区分技术解释与生物解释?
测序深度不同的细胞如何比较
QUESTION当每个细胞捕获的总 UMI 不同时,怎样比较相对表达而不把测序深度当成生物学?
INTUITION · 先建立直觉
像比较不同长度文章中某词的使用倾向,需要先考虑总字数;但换算成比例也不能恢复从未被采到的词。类比不是归一化模型。
CLINICAL CASE · 肺纤维化情境
肺巨噬细胞常有更高 RNA 含量;若直接比较 raw counts,它们可能仅因总 UMI 高而显得所有基因都高。
WHY / PRINCIPLE
归一化调整技术尺度并稳定方差,但会改变数值含义;原始 counts、normalized data 与 scaled data 不能混用。
WORKFLOW · 数据怎样变化
- 01保留 raw counts
- 02估计 size factor 或建模测序深度
- 03log/variance stabilization
- 04用诊断图检查深度残留
Raw Matrix
深浅同时受到真实表达与测序深度影响。
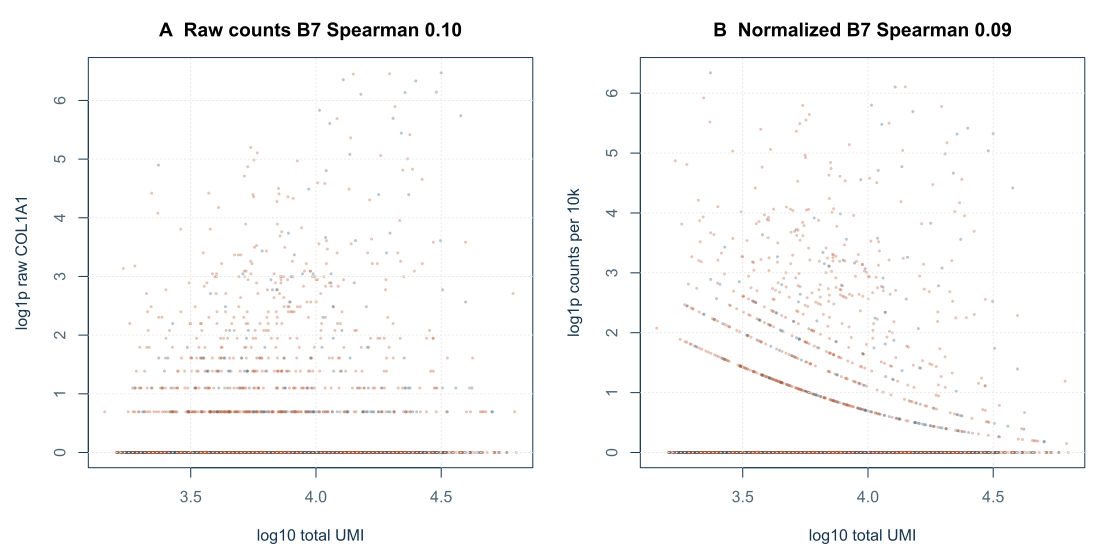
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · scripts/figures/scrna/generate-gse135893-foundations.R
- HASH
041c1a9d0011…
逐项核对数值、适用条件与下一步
01确认纵轴是哪一 assay/layer通过快速筛查
Assay/layer 身份
在读数值前确认 raw counts、log-normalized data 或 scaled residual,三者单位不可混用。
- 统计单位
- cell representation
- 单位
- layer identity
33,694 genes × 8,853 stratified cells
GSE135893 public-data-derived
- PASS图注、代码和对象 layer 使用同一名称与变换
- REVIEW只写 expression,未给 scale factor 或 log 变换
- STOP把 scaled residual 当作 UMI 或 fold change
适用范围:本图使用固定 10,000 scale factor;其他方法应报告自己的 size-factor/model。
联合因素:assay layer · scale factor · log transform
log1p(raw count / cell total UMI × 10,000)纵轴 2.0 表示变换后的相对表达,不是 2 个 UMI。
输入、变换与输出单位已经明确记录。
02查看归一化前后总 UMI 相关性需要情境化复核
COL1A1 与 library size 的 Spearman 相关
比较同一批细胞在 raw 与 normalized 层中,基因表达与 total UMI 的秩相关。
- 统计单位
- cell representation stratified by cell type
- 单位
- Spearman rho
log1p raw COL1A1 vs log10 total UMI
log1p CP10K COL1A1 vs log10 total UMI
- PASS绝对相关下降且多个代表基因/PC 的深度关联同时减弱
- REVIEW单基因变化很小,需检查全局 PC 与细胞类型分层
- STOP归一化后主要 PC 仍被 nCount 支配
适用范围:单个 COL1A1 相关仅为演示诊断,不能代表全矩阵归一化成功。
联合因素:gene abundance · cell type · library size
|ρ|: 0.1049 → 0.0877相关只从 0.1049 降到 0.0877,差值很小;不能因此宣布归一化完成。
单基因相关弱且变化有限,必须扩展到多个基因、PC 与细胞类型诊断。
03比较不同细胞类型的分布需要情境化复核
细胞类型结构保留
归一化降低技术尺度后,已知 broad cell type 的成套 marker 与邻域仍应可辨认。
- 统计单位
- cell neighborhood; donor for disease inference
- 单位
- % same-type neighbors
同一真实分析子集
donor × cell-type stratified
- PASS技术相关下降,同时邻域和 marker 程序跨 donor 保留
- REVIEW同类邻居率高但由标签泄漏、单 donor 或强 batch 解释
- STOP不同谱系被归一化后压成同一表示
适用范围:同类邻居率不是越高越好;它只用于检查已知 broad labels 是否被破坏。
联合因素:marker program · donor · neighbor graph
same-type neighbors / 15 neighbors,逐细胞后取均值88.99% 支持 broad structure 可见,但不证明亚群或疾病状态正确。
结构保留需要与 batch/source 诊断同时读,单一邻居率不足以验收。
04检查低计数基因零膨胀通过快速筛查
零值与低计数信息
统计目标基因零值比例,并区分生物低表达、有限捕获与过滤造成的缺失。
- 统计单位
- cell
- 单位
- zero/non-zero
COL1A1 cell-level scatter
归一化不能恢复未捕获 RNA
- PASS零值作为测量结果保留,模型与图注说明抽样限制
- REVIEW用平滑/imputation 仅作探索并保留原始层
- STOP把填补后的表达当作直接测量
适用范围:适用于 UMI count 数据;不同技术的检测限需单独评估。
联合因素:捕获效率 · 真实表达 · imputation
zero fraction = cells with count=0 / included cellsCP10K 改变非零值尺度,但 raw count=0 仍然为 0。
本流程没有用归一化制造未观测分子。
05保留原始 counts 供 pseudobulk通过快速筛查
Raw counts 可追溯性
确认归一化没有覆盖原始整数计数,后续 pseudobulk 能回到同一细胞集合。
- 统计单位
- data object
- 单位
- provenance
GSE135893 Matrix Market counts
separate sparse matrix in generator
- PASSraw 与 normalized 分层保存,barcode 顺序和 metadata hash 可追溯
- REVIEW只导出 normalized matrix,仍可从原始缓存重建
- STOPraw counts 被覆盖或 barcode 对齐无法复核
适用范围:所有 count-model DE 均需要原始或等价计数层。
联合因素:layer · barcode order · input hash
normalized = f(raw); raw remains immutable浏览器不提交 1 GB 矩阵,但生成脚本记录四个输入文件与固定种子。
派生产物与原始本地缓存分离,保留可追溯链。
先锁定 cell representation;疾病检验仍以 donor 为重复,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
归一化后仍由 nCount 主导 PCA,或把 scaled values 当原始表达量解释时停止下游推断。
回到 raw UMI counts 与 library size 定位冲突来自哪个独立单位,并用 LogNormalize 的诊断输出复算;冲突未解释前只保留描述性结果。
支持建立适合降维和可视化的相对表达表示。
不能恢复 dropout 中缺失的分子,也不能消除所有批次或组成偏差。
VALIDATION · 下一层证据
- 留出至少一个 cell representation;疾病检验仍以 donor 为重复 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
按公式复核归一化 · R 可运行示例
把软件输出与 log(1 + count/total × 10000) 逐元素比较。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 600 genes x 120 cells; not GSE135893
library(Seurat)
set.seed(104729)
counts <- matrix(rpois(600 * 120, lambda = rep(seq(0.2, 3, length.out = 600), 120)), nrow = 600)
for (k in 0:2) counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] <- counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] + 4L
counts[1:12, 1:6] <- counts[1:12, 1:6] + 20L
rownames(counts) <- c(paste0("MT-", 1:12), paste0("GENE", 13:600))
colnames(counts) <- paste0("cell", 1:120)
object <- CreateSeuratObject(counts = counts, min.cells = 0, min.features = 0)
object$donor <- rep(paste0("D", 1:4), length.out = 120)
stopifnot(all(dim(object) == c(600L, 120L)), all(colSums(counts) > 0))
object <- NormalizeData(object, normalization.method = "LogNormalize", scale.factor = 10000, verbose = FALSE)
normalized <- as.matrix(LayerData(object, assay = "RNA", layer = "data"))
expected <- log1p(sweep(counts, 2, colSums(counts), "/") * 10000)
error <- max(abs(normalized - expected))
print(error)
stopifnot(error < 1e-8)
stopifnot(all(as.matrix(LayerData(object, assay = "RNA", layer = "counts")) == counts))
print(sessionInfo())测序深度校正不能消除批次、细胞周期或不同细胞类型的总 RNA 含量差异。
按公式复核归一化 · Python 可运行示例
把软件输出与 log(1 + count/total × 10000) 逐元素比较。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 120 cells x 600 genes; not GSE135893
import numpy as np
import scanpy as sc
from anndata import AnnData
from importlib.metadata import version
rng = np.random.default_rng(104729)
counts = rng.poisson(np.linspace(0.2, 3, 600), size=(120, 600))
for k in range(3):
counts[k*40:(k+1)*40, 20+k*40:60+k*40] += 4
counts[:6, :12] += 20
adata = AnnData(counts.astype(float))
adata.var_names = [f"MT-{i+1}" if i < 12 else f"GENE{i+1}" for i in range(600)]
adata.obs_names = [f"cell{i+1}" for i in range(120)]
adata.obs["donor"] = [f"D{i % 4 + 1}" for i in range(120)]
adata.layers["counts"] = adata.X.copy()
assert adata.shape == (120, 600) and np.all(counts.sum(axis=1) > 0)
sc.pp.normalize_total(adata, target_sum=10000)
sc.pp.log1p(adata)
expected = np.log1p(counts / counts.sum(axis=1, keepdims=True) * 10000)
error = np.max(np.abs(adata.X - expected))
print(error)
assert error < 1e-8
assert np.array_equal(adata.layers["counts"], counts)
print({p: version(p) for p in ("scanpy", "anndata", "numpy")})测序深度校正不能消除批次、细胞周期或不同细胞类型的总 RNA 含量差异。
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持建立适合降维和可视化的相对表达表示。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cell representation;疾病检验仍以 donor 为重复 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 LogNormalize 误差来源的测量,最能区分技术解释与生物解释?
为什么不直接使用全部基因
QUESTION哪些基因携带可复现的细胞状态差异,而不是只反映平均表达和抽样噪声?
INTUITION · 先建立直觉
像在嘈杂会议里挑出真正区分发言者的词;高频口头禅不一定最有辨识力。类比不是特征选择证据。
CLINICAL CASE · 肺纤维化情境
肺组织的核糖体、线粒体和管家基因很丰富,但未必最能区分成纤维细胞、上皮和免疫状态。
WHY / PRINCIPLE
HVG 方法在平均表达依赖的方差背景上寻找额外变异;数量是敏感性参数,不是越多越好。
WORKFLOW · 数据怎样变化
- 01估计均值—方差关系
- 02选择超出技术趋势的基因
- 03排查应激/细胞周期主导
- 04比较不同 nfeatures 的表示稳定性
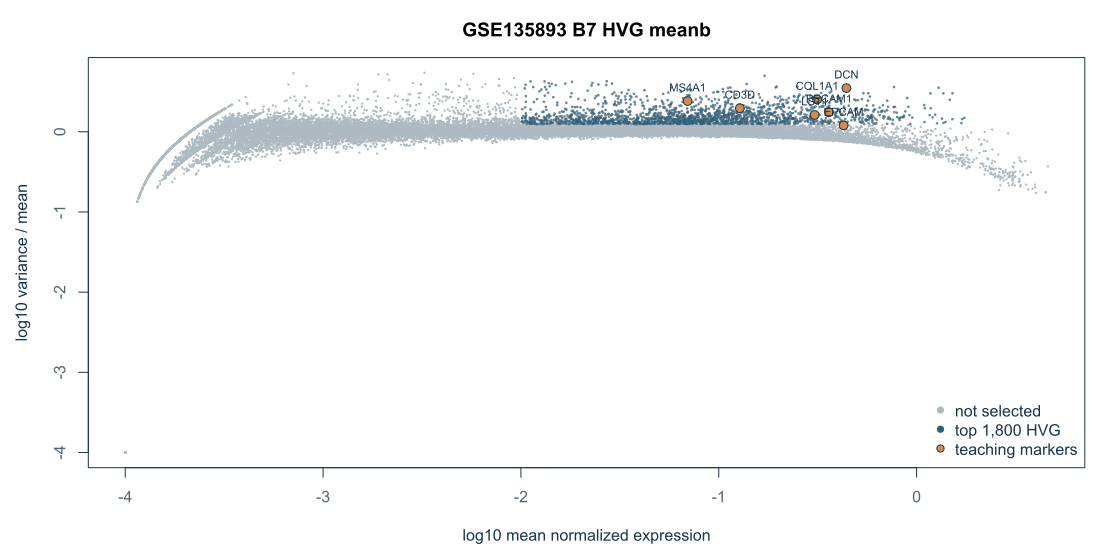
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · scripts/figures/scrna/generate-gse135893-foundations.R
- HASH
2b7d339a2371…
逐项核对数值、适用条件与下一步
01横轴读平均表达通过快速筛查
基因均值—变异坐标
横轴为跨细胞平均 log-normalized 表达,纵轴为 variance/mean;先读坐标再看入选颜色。
- 统计单位
- gene across stratified cells
- 单位
- dispersion
GSE135893 matrix
固定分析子集
- PASS入选基因位于各自平均表达背景之上的高变异区域
- REVIEW极低均值基因因少量非零值获得高 dispersion
- STOP忽略均值依赖,直接按原始方差排序
适用范围:本图使用教学实现的 dispersion 排名;正式 Seurat/Scanpy 应记录 flavor/version。
联合因素:mean · variance · non-zero cells
dispersion = variance / max(mean, 1e-8)同样方差在低均值与高均值基因上的解释不同。
图同时显示均值与变异,避免把高表达自动等同于高信息。
02纵轴读标准化变异需要情境化复核
HVG 数量与选择比例
记录入选基因数及其占全部基因的比例,作为敏感性参数而非标准答案。
- 统计单位
- gene
- 单位
- selected genes
top dispersion after MT/RPL/RPS exclusion
1,800 / 33,694
- PASS预先设定主分析值,并比较相邻 nfeatures 的邻居/PC 稳定性
- REVIEW1,000–3,000 改变核心邻域或 marker 解释
- STOP不断调 nfeatures 直到得到想要的 UMAP
适用范围:1,800 是本课程派生值,不是跨组织最佳值。
联合因素:nfeatures · sample size · heterogeneity
1,800 / 33,694 × 100 = 5.34%比例小不代表其余基因无生物意义;HVG 只服务于表示学习。
尚需用相邻 nfeatures 比较邻居重叠,才能判断 1,800 对当前数据是否稳健。
03看入选基因覆盖哪些程序暂停解释
技术/免疫程序占比审计
检查 top HVG 是否被 immunoglobulin、线粒体、核糖体或应激基因支配。
- 统计单位
- gene list
- 单位
- genes in top 20
当前公开数据派生列表
当前 top 20
- PASS多个独立生物程序进入列表,且单一技术/谱系程序不支配前列
- REVIEWtop 20 中 >50% 来自一个高度扩增程序,需要分层或排除敏感性
- STOP几乎全部为 MT-/RPL/RPS 或单样本应激基因
适用范围:17/20 是当前分析子集的真实结果,提示需要诊断,不是质量失败阈值。
联合因素:gene family · cell-type abundance · donor recurrence
count(gene family in top 20) / 2017/20 为 IG/JCHAIN,说明 B-cell/浆细胞程序可能支配全局 HVG。
当前 top HVG 过度集中于免疫球蛋白程序;直接 PCA 可能首先分离该谱系而掩盖其他结构。
04检查技术基因是否主导需要情境化复核
跨 donor HVG 复现
在每位 donor 或 donor 分组中重算变异排序,检查候选是否仅由单一样本产生。
- 统计单位
- donor
- 单位
- recurrence fraction
8,853 cells
必须补做
- PASS核心程序在多数 donor 的 top list 中重复出现
- REVIEW总体可见但在少数 donor 中缺失
- STOP关键 HVG 只来自单 donor 或单批次
适用范围:不能用 pooled cell count 替代 donor-level recurrence。
联合因素:donor · cell type · sampling depth
每基因 recurrence = donors whose HVG list contains gene / eligible donors当前 pooled Figure 不能回答跨 donor 复现,因此状态为 review。
缺少 donor-specific HVG overlap 数值,不能宣称特征选择稳定。
05比较跨 donor 稳定性通过快速筛查
HVG 只用于表示、不用于 DE
确认入选 HVG 不会成为差异表达的预筛选集合。
- 统计单位
- gene
- 单位
- analysis set
PCA/neighbor input
donor-level pseudobulk
- PASS表示学习用 HVG,DE 在预定义 count-filter 后使用独立基因宇宙
- REVIEW只保存 HVG matrix,但可从 raw counts 恢复
- STOP只在 1,800 HVG 中检验 DE 并报告为全基因结果
适用范围:DE 的低计数过滤需要独立预设,不由 UMAP/HVG 可见性决定。
联合因素:analysis purpose · multiple testing universe · raw counts
HVG set ≠ DE test set未入选 PCA 的基因仍可能在 donor-level DE 中有稳定效应。
课程数据契约保留全 raw matrix,HVG 不限制后续 pseudobulk。
先锁定 gene across cells, checked across donors,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
HVG 几乎全是线粒体、核糖体、应激或单一样本特异基因时暂停 PCA。
回到 normalized expression 的均值与变异 定位冲突来自哪个独立单位,并用 Seurat vst HVG 的诊断输出复算;冲突未解释前只保留描述性结果。
支持聚焦对细胞状态结构最有信息的特征。
不能证明未入选基因不重要,也不能作为差异表达筛选。
VALIDATION · 下一层证据
- 留出至少一个 gene across cells, checked across donors 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
选择 HVG 后保留全基因 · R 可运行示例
在 counts 层拟合变异模型,记录被选中基因并检查其占比。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 600 genes x 120 cells; not GSE135893
library(Seurat)
set.seed(104729)
counts <- matrix(rpois(600 * 120, lambda = rep(seq(0.2, 3, length.out = 600), 120)), nrow = 600)
for (k in 0:2) counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] <- counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] + 4L
counts[1:12, 1:6] <- counts[1:12, 1:6] + 20L
rownames(counts) <- c(paste0("MT-", 1:12), paste0("GENE", 13:600))
colnames(counts) <- paste0("cell", 1:120)
object <- CreateSeuratObject(counts = counts, min.cells = 0, min.features = 0)
object$donor <- rep(paste0("D", 1:4), length.out = 120)
stopifnot(all(dim(object) == c(600L, 120L)), all(colSums(counts) > 0))
object <- NormalizeData(object, normalization.method = "LogNormalize", scale.factor = 10000, verbose = FALSE)
object <- FindVariableFeatures(object, selection.method = "vst", nfeatures = 120, verbose = FALSE)
hvg <- VariableFeatures(object)
print(head(hvg, 10))
print(c(selected = length(hvg), all_genes = nrow(object), mt_selected = sum(grepl("^MT-", hvg))))
stopifnot(length(hvg) == 120L, nrow(object) == 600L)
print(sessionInfo())HVG 是建模特征,不是疾病差异基因,也不是因果靶点。
选择 HVG 后保留全基因 · Python 可运行示例
在 counts 层拟合变异模型,记录被选中基因并检查其占比。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 120 cells x 600 genes; not GSE135893
import numpy as np
import scanpy as sc
from anndata import AnnData
from importlib.metadata import version
rng = np.random.default_rng(104729)
counts = rng.poisson(np.linspace(0.2, 3, 600), size=(120, 600))
for k in range(3):
counts[k*40:(k+1)*40, 20+k*40:60+k*40] += 4
counts[:6, :12] += 20
adata = AnnData(counts.astype(float))
adata.var_names = [f"MT-{i+1}" if i < 12 else f"GENE{i+1}" for i in range(600)]
adata.obs_names = [f"cell{i+1}" for i in range(120)]
adata.obs["donor"] = [f"D{i % 4 + 1}" for i in range(120)]
adata.layers["counts"] = adata.X.copy()
assert adata.shape == (120, 600) and np.all(counts.sum(axis=1) > 0)
sc.pp.normalize_total(adata, target_sum=10000)
sc.pp.log1p(adata)
sc.pp.highly_variable_genes(adata, flavor="seurat_v3", n_top_genes=120, layer="counts")
hvg = adata.var_names[adata.var["highly_variable"]]
print(hvg[:10].tolist())
print({"selected": len(hvg), "all_genes": adata.n_vars, "mt_selected": int(hvg.str.startswith("MT-").sum())})
assert len(hvg) == 120 and adata.n_vars == 600
print({p: version(p) for p in ("scanpy", "anndata", "numpy")})HVG 是建模特征,不是疾病差异基因,也不是因果靶点。
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持聚焦对细胞状态结构最有信息的特征。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 gene across cells, checked across donors 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 Seurat vst HVG 误差来源的测量,最能区分技术解释与生物解释?
主要变化轴如何产生
QUESTION如何把数千个基因压缩成少量仍能解释主要表达变化的坐标?
INTUITION · 先建立直觉
像把一组高度相关的化验指标概括成几个综合维度;每个维度是加权组合,不是一个真实基因。类比不是 PCA 数学证明。
CLINICAL CASE · 肺纤维化情境
纤维化肺中免疫—基质差异可能主导前几个 PC,而细胞周期或测序深度也可能成为伪主轴。
WHY / PRINCIPLE
PCA 寻找正交的线性变化轴;PC 选择应结合方差、loadings、技术相关和下游稳定性。
WORKFLOW · 数据怎样变化
- 01缩放选定基因
- 02计算 PCA
- 03查看 elbow 与 loadings
- 04检查 PC 与 QC/batch/biology 的关联
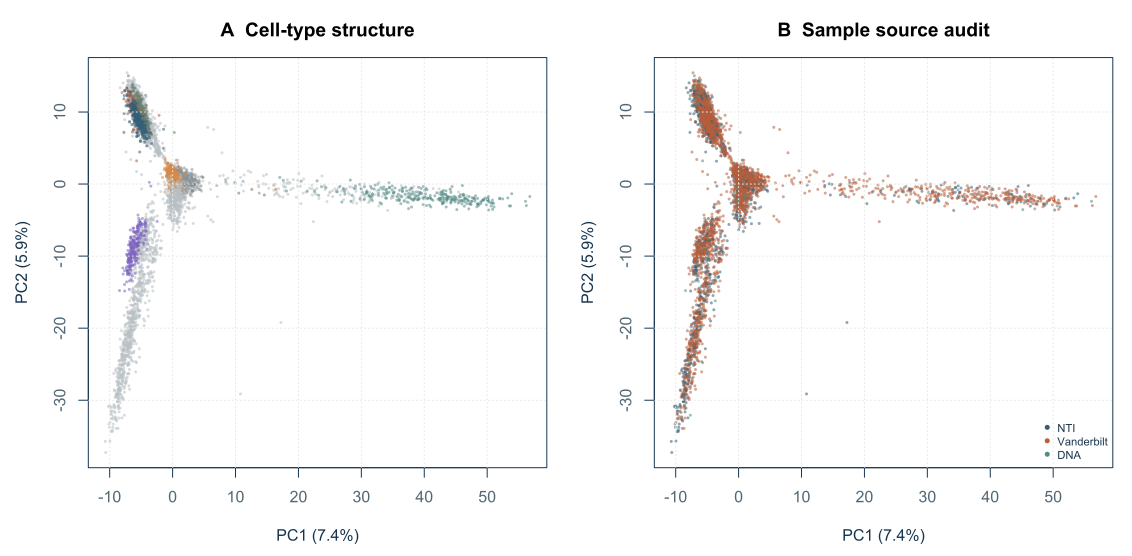
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · scripts/figures/scrna/generate-gse135893-foundations.R
- HASH
57a0bb0bb0c3…
逐项核对数值、适用条件与下一步
01先看每个 PC 解释方差通过快速筛查
PC 解释的总标准化方差
每个 PC 的 eigenvalue 除以缩放后 1,800 个 HVG 的总方差,而非只除以前 30 PC。
- 统计单位
- PC axis
- 单位
- % total scaled variance
total scaled-HVG variance
total scaled-HVG variance
- PASS分母为全部缩放特征总方差,且报告 scree/elbow 与累计方差
- REVIEW只报告前 30 PC 内部比例
- STOP把 PC1/PC2 二维分离度当作全部数据解释度
适用范围:当前数值来自固定 1,800 HVG 与 8,853 细胞分析子集。
联合因素:HVG count · scaling · number of PCs
variance ratio = PC eigenvalue / 1,800PC1=7.44%,PC2=5.89%;其余变化仍分布在更多维度。
分母已修正为全部缩放 HVG 方差,避免夸大前两个 PC。
02再读正负 loadings 基因需要情境化复核
PC loading 基因程序
同时查看每个 PC 正负 loading 的成套基因,而不是用散点位置猜测生物学。
- 统计单位
- gene loading
- 单位
- loading coefficient
scaled matrix
irlba deterministic run
- PASS正负 loading 均形成可解释且跨 donor 的基因程序
- REVIEWloading 混合多个谱系或被 IG genes 支配
- STOPtop loadings 主要为技术/QC 基因或单 donor 特异
适用范围:当前 top HVG 有 IG 富集,loading 必须与上一节警告一起读。
联合因素:positive loadings · negative loadings · gene family
按 |loading| 排序,并对 gene sets 做富集/人工审查若 PC1 主要由 IGHV genes 驱动,它更可能先分离 B/plasma 程序,而非疾病主轴。
HVG 审计已提示免疫球蛋白富集,因此必须检查 loading 后才能给 PC 命名。
03按 donor/condition/cell type 着色需要情境化复核
PC 与生物标签的关系
在同一坐标上分别按 broad cell type、condition 与 donor/source 着色,区分生物结构和设计来源。
- 统计单位
- cell score; donor/source diagnostic
- 单位
- PC score
donor×cell-type stratified
不能由点数替代
- PASS主要谱系跨多个 donor 重叠出现,condition 不与单一 source 完全重合
- REVIEW谱系清楚但 source 仍形成局部结构
- STOP某 PC 几乎等同单 donor、sample source 或 nCount
适用范围:PCA 点是细胞;疾病效应仍须 donor-level 模型。
联合因素:cell type · condition · donor · source
对 PC score 分别拟合 cell type、donor、source、nCount 的解释度Panel A 显示谱系结构;Panel B 用同一坐标审计 sample source。
可见谱系结构,但 source/condition 设计相关性仍需 Integration 章节量化。
04检查 nCount 与 percent.mt 相关需要情境化复核
PC 与 QC 指标相关
逐 PC 计算与 log nCount、nFeature 和 percent.mt 的相关,并按 donor 分层复核。
- 统计单位
- cell with donor-stratified diagnostic
- 单位
- Spearman rho
需补充诊断表
30 correlations plus donor facets
- PASS关键 PCs 的 QC 相关较弱,或技术轴被明确排除并做敏感性分析
- REVIEW|ρ|=0.2–0.4 且生物/技术解释混合
- STOP用于 neighbors 的主要 PC 与 nCount/percent.mt |ρ|>0.4
适用范围:0.2/0.4 为本课快速筛查层;正式判断看散点、非线性和细胞类型分层。
联合因素:nCount · nFeature · percent.mt · cell type
Spearman(PC score, QC metric),全局和 broad cell type 内分别计算全局相关可能由细胞类型 RNA 含量造成,不能只看单一 ρ。
当前派生 Figure 未呈现 QC 相关表,因此不能直接批准全部 30 PCs。
05比较 dims 敏感性需要情境化复核
dims 敏感性
在相邻 PC 数下重建 kNN,比较每细胞邻居重叠和主要结论。
- 统计单位
- cell neighborhood
- 单位
- Jaccard overlap
UMAP/neighbor input
待重算
- PASS15–25 PCs 的 median neighbor overlap ≥0.8,主要群跨 donor 保留
- REVIEWoverlap 0.6–0.8 或仅稀有群改变
- STOPoverlap <0.6,或疾病结论只在一个 dims 值出现
适用范围:阈值是本课敏感性分层;应预设而非事后挑图。
联合因素:dims · k · neighbor overlap
Jaccard(N_k^dimsA, N_k^dimsB),逐细胞后报告分布当前只有 dims=20 主分析,所以稳定性仍为未完成检查。
没有相邻 dims 对照不能把当前 PCA→neighbor 视为唯一结构。
先锁定 cell representation with donor-aware diagnostics,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
前几个 PC 主要由测序深度、线粒体或单一 donor 决定时不能直接建图。
回到 scaled HVG matrix 定位冲突来自哪个独立单位,并用 RunPCA 的诊断输出复算;冲突未解释前只保留描述性结果。
支持构建低维线性表示并为邻居图提供输入。
不能单独证明离散细胞类型或非线性发育轨迹。
VALIDATION · 下一层证据
- 留出至少一个 cell representation with donor-aware diagnostics 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
检查 PCA 的维度与载荷 · R 可运行示例
检查细胞得分、基因载荷和方差量是否都存在。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 600 genes x 120 cells; not GSE135893
library(Seurat)
set.seed(104729)
counts <- matrix(rpois(600 * 120, lambda = rep(seq(0.2, 3, length.out = 600), 120)), nrow = 600)
for (k in 0:2) counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] <- counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] + 4L
counts[1:12, 1:6] <- counts[1:12, 1:6] + 20L
rownames(counts) <- c(paste0("MT-", 1:12), paste0("GENE", 13:600))
colnames(counts) <- paste0("cell", 1:120)
object <- CreateSeuratObject(counts = counts, min.cells = 0, min.features = 0)
object$donor <- rep(paste0("D", 1:4), length.out = 120)
stopifnot(all(dim(object) == c(600L, 120L)), all(colSums(counts) > 0))
object <- NormalizeData(object, normalization.method = "LogNormalize", scale.factor = 10000, verbose = FALSE)
object <- FindVariableFeatures(object, selection.method = "vst", nfeatures = 120, verbose = FALSE)
object <- ScaleData(object, features = VariableFeatures(object), verbose = FALSE)
object <- RunPCA(object, features = VariableFeatures(object), npcs = 10, seed.use = 104729, verbose = FALSE)
scores <- Embeddings(object, "pca")
loadings <- Loadings(object, "pca")
print(head(sort(abs(loadings[, 1]), decreasing = TRUE), 8))
print(Stdev(object, "pca")^2)
stopifnot(all(dim(scores) == c(120L, 10L)), all(is.finite(scores)))
print(sessionInfo())PCA 能压缩变化方向,不能单独识别 batch 来源或证明疾病机制。
检查 PCA 的维度与载荷 · Python 可运行示例
检查细胞得分、基因载荷和方差量是否都存在。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 120 cells x 600 genes; not GSE135893
import numpy as np
import scanpy as sc
from anndata import AnnData
from importlib.metadata import version
rng = np.random.default_rng(104729)
counts = rng.poisson(np.linspace(0.2, 3, 600), size=(120, 600))
for k in range(3):
counts[k*40:(k+1)*40, 20+k*40:60+k*40] += 4
counts[:6, :12] += 20
adata = AnnData(counts.astype(float))
adata.var_names = [f"MT-{i+1}" if i < 12 else f"GENE{i+1}" for i in range(600)]
adata.obs_names = [f"cell{i+1}" for i in range(120)]
adata.obs["donor"] = [f"D{i % 4 + 1}" for i in range(120)]
adata.layers["counts"] = adata.X.copy()
assert adata.shape == (120, 600) and np.all(counts.sum(axis=1) > 0)
sc.pp.normalize_total(adata, target_sum=10000)
sc.pp.log1p(adata)
sc.pp.highly_variable_genes(adata, flavor="seurat_v3", n_top_genes=120, layer="counts")
work = adata[:, adata.var["highly_variable"]].copy()
sc.pp.scale(work, max_value=10)
sc.pp.pca(work, n_comps=10, svd_solver="arpack", random_state=104729)
scores = work.obsm["X_pca"]
order = np.argsort(np.abs(work.varm["PCs"][:, 0]))[-8:][::-1]
print(work.var_names[order].tolist())
print(work.uns["pca"]["variance_ratio"])
assert scores.shape == (120, 10) and np.isfinite(scores).all()
print({p: version(p) for p in ("scanpy", "anndata", "numpy")})PCA 能压缩变化方向,不能单独识别 batch 来源或证明疾病机制。
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持构建低维线性表示并为邻居图提供输入。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cell representation with donor-aware diagnostics 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 RunPCA 误差来源的测量,最能区分技术解释与生物解释?
PCA → Neighbor Graph → UMAP
QUESTION细胞相似性怎样变成邻居关系,又怎样被投影为二维图?
INTUITION · 先建立直觉
像先按共同特征建立熟人网络,再把网络画在纸上;纸上位置是布局,不是现实地理距离。类比不是图算法证据。
CLINICAL CASE · 肺纤维化情境
在肺纤维化数据中,成纤维细胞状态可能连续变化;UMAP 岛屿形状不能替代邻居图与 marker 检查。
WHY / PRINCIPLE
Clustering 与 UMAP 都依赖 neighbor graph;UMAP 不是聚类输入,也不是统计检验。
WORKFLOW · 数据怎样变化
- 01选择 PCs
- 02构建 kNN/SNN 图
- 03并行运行社区发现与 UMAP
- 04按 sample/QC/marker 复核
同一个 neighbor structure,两种不同输出。 聚类回答“如何分组”,UMAP 回答“如何把局部关系画出来”。
UMAP 不是一步算出来的:PCA → 邻居图 → UMAP
阶段 1 / 6:表达矩阵。 每一列是一个细胞,每一行是一个基因。这里从已经完成细胞间归一化的表达矩阵讲起;归一化不是后面的基因尺度化。
C4:矩阵第 4 列 → PC 点 → 图节点。黑框 / 黑圈保持身份对应,变换数据形式不会新增细胞。
跟随同一批 12 个细胞走过矩阵、基因子集、尺度化、PC 空间、邻居图、二维展示。矩阵颜色、点位、边与群标签均为原创手工示意,并非运行 PCA / UMAP 或社区检测后的结果。
原创教学交互 · 模拟数据 · 未复制论文 Figure解释 scRNA 分析中各数据对象的先后依赖,以及为什么 cluster 标签来自图而不是来自 UMAP 图片。
不能仅凭二维散点的分离程度断定细胞群的真实性;群结构需要 marker、样本重复与 QC 证据支撑。
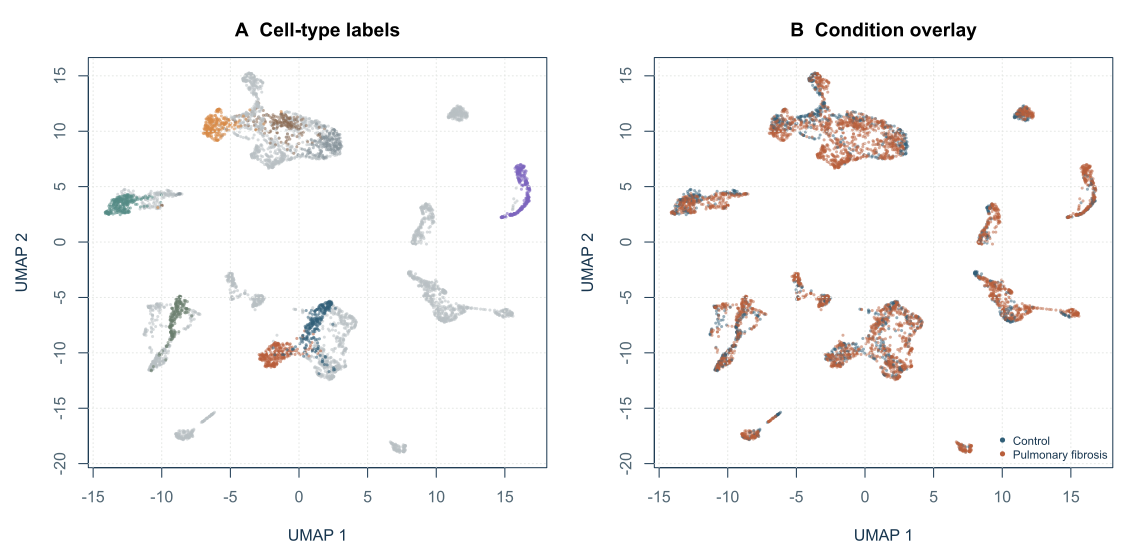
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · scripts/figures/scrna/generate-gse135893-foundations.R
- HASH
9e69e72efeff…
逐项核对数值、适用条件与下一步
01先确认 UMAP 点和颜色编码通过快速筛查
UMAP 编码与点数
确认每点是细胞、坐标来自真实 UMAP 计算、颜色分别表示 cell type 或 condition。
- 统计单位
- cell for representation; donor for disease inference
- 单位
- UMAP coordinates
20 PCs, cosine metric
固定分层展示子集
- PASS图注同时给出坐标方法、分析细胞数和展示抽样规则
- REVIEW只给显示点数,未说明推断使用的对象
- STOP把手绘/其他降维坐标称为 UMAP
适用范围:展示子集只服务读图,不能用于 donor-level 统计。
联合因素:coordinate method · display sampling · encoding
UMAP(20 PCs, n_neighbors=30, min_dist=0.3, cosine, seed=135893)4,800 点是 8,853 分析细胞的固定展示子集,不是疾病比较样本量。
坐标方法和抽样来源可追溯,没有把模拟布局冒充 UMAP。
02按 sample 检查覆盖需要情境化复核
k=15 broad-cell-type 邻居一致率
对每个细胞计算 15 个 PCA 邻居中与其 broad cell type 标签相同的比例,再取均值。
- 统计单位
- cell neighborhood summarized across donors
- 单位
- % same-label neighbors
GSE135893 analysis subset
PCA space diagnostic
- PASS同类邻居率高且每个 major type 均跨多个 donor
- REVIEW总体高,但稀有群低或由单 donor 贡献
- STOP高一致率源自先用标签构建坐标或仅一个 donor
适用范围:该指标评估已知 broad structure,不是聚类准确率或生物真值。
联合因素:cell type · donor · k
mean_i[same-label neighbors_i / 15]88.99% 表明 broad labels 在 PCA 邻域中可见;仍不能证明亚群或疾病状态。
还需按 cell type 与 donor 分解,避免总体均值掩盖稀有群失败。
03回到 neighbor graph 看连接需要情境化复核
Sample-source 邻居同源率
计算每个细胞的 15 个 PCA 邻居中来自同一 Sample_Source 的比例,诊断来源结构。
- 统计单位
- cell neighborhood with donor/source labels
- 单位
- % same-source neighbors
uncorrected PCA neighbors
需按标签置换估计
- PASS同源率接近标签置换基线且生物结构保留
- REVIEW高于置换基线,但每类细胞内程度不同
- STOP来源几乎完全分离,或 source 与 condition 不可识别地混杂
适用范围:60.42% 必须和 source 组成基线、cell type 分层一起读。
联合因素:sample source · source proportions · cell type
mean_i[same-source neighbors_i / 15],再与置换分布比较未计算置换基线前,60.42% 不能直接叫高或低。
实际同源率已给出,但缺少可比基线,因此不能凭数值宣布 batch effect。
04叠加 QC 与 marker需要情境化复核
UMAP 与 QC 重叠
在固定坐标上叠加 nCount、nFeature、percent.mt,检查岛屿或桥是否由质量尾部构成。
- 统计单位
- cell with donor summaries
- 单位
- QC metric
未叠加 QC
nCount/nFeature/percent.mt available
- PASS主要结构不与任何单一 QC 尾部重合
- REVIEW局部区域富集一个 QC 指标,需要按 cell type/donor 复核
- STOP候选群主要由低复杂度或高 percent.mt 细胞组成
适用范围:连续 QC 颜色比事先二分 pass/fail 更适合诊断。
联合因素:nCount · nFeature · percent.mt · donor
按 UMAP neighborhood 汇总 QC median/MAD,并比较 donor当前 Figure 没有 QC overlay,所以该检查不能被默认判定为通过。
缺少 QC overlay 是明确信息缺口,不用漂亮的 cell-type 分离代替。
05测试 k/dims/seed 的邻居重叠需要情境化复核
参数与随机种子稳定性
固定细胞和 PCA,改变 k、min_dist 或 seed,比较邻居集合;不比较岛屿外观。
- 统计单位
- cell neighborhood
- 单位
- Jaccard overlap
UMAP construction
135893
- PASS相邻 k/seed 下核心邻居 Jaccard ≥0.8,结论不依赖单图
- REVIEW0.6–0.8 或仅边界细胞变化
- STOP<0.6,或候选群只在一个 seed/参数出现
适用范围:Jaccard 分层是课程敏感性规则,不是 UMAP 官方验收阈值。
联合因素:k · dims · seed · neighbor Jaccard
比较 PCA-kNN 集合;UMAP 仅作同步显示当前只有 seed=135893 主图,尚不能声称随机种子稳定。
单一 UMAP 不提供稳定性证据。
先锁定 cell nodes; donor remains replication unit,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
任一群由单 donor 贡献 >80%、QC flag 细胞占比 >30%,或相邻 k/dims/seed 的邻居 Jaccard <0.60 时,停止命名和下游比较。
回到 PCA scores 与 k/dims 定位冲突来自哪个独立单位,并用 FindNeighbors/sc.pp.neighbors 的诊断输出复算;冲突未解释前只保留描述性结果。
支持描述表达邻域和候选状态结构。
不能从二维距离证明空间邻近、真实时间、通讯或因果。
VALIDATION · 下一层证据
- 留出至少一个 cell nodes; donor remains replication unit 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
区分邻居图与 UMAP 坐标 · R 可运行示例
分别检查图的维度、边权和二维坐标;两种对象回答不同问题。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 600 genes x 120 cells; not GSE135893
library(Seurat)
set.seed(104729)
counts <- matrix(rpois(600 * 120, lambda = rep(seq(0.2, 3, length.out = 600), 120)), nrow = 600)
for (k in 0:2) counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] <- counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] + 4L
counts[1:12, 1:6] <- counts[1:12, 1:6] + 20L
rownames(counts) <- c(paste0("MT-", 1:12), paste0("GENE", 13:600))
colnames(counts) <- paste0("cell", 1:120)
object <- CreateSeuratObject(counts = counts, min.cells = 0, min.features = 0)
object$donor <- rep(paste0("D", 1:4), length.out = 120)
stopifnot(all(dim(object) == c(600L, 120L)), all(colSums(counts) > 0))
object <- NormalizeData(object, normalization.method = "LogNormalize", scale.factor = 10000, verbose = FALSE)
object <- FindVariableFeatures(object, selection.method = "vst", nfeatures = 120, verbose = FALSE)
object <- ScaleData(object, features = VariableFeatures(object), verbose = FALSE)
object <- RunPCA(object, features = VariableFeatures(object), npcs = 10, seed.use = 104729, verbose = FALSE)
object <- FindNeighbors(object, reduction = "pca", dims = 1:10, k.param = 15, graph.name = c("lesson_nn", "lesson_snn"), verbose = FALSE)
object <- FindNeighbors(object, reduction = "pca", dims = 1:10, k.param = 15, return.neighbor = TRUE, compute.SNN = FALSE, graph.name = "lesson_knn", verbose = FALSE)
object <- RunUMAP(object, nn.name = "lesson_knn", umap.method = "uwot", min.dist = 0.3, seed.use = 104729, verbose = FALSE)
graph <- object[["lesson_snn"]]
xy <- Embeddings(object, "umap")
print(c(cells = nrow(graph), graph_nonzero = Matrix::nnzero(graph), umap_dimensions = ncol(xy)))
stopifnot(all(dim(graph) == c(120L, 120L)), all(dim(xy) == c(120L, 2L)), all(is.finite(xy)))
print(sessionInfo())二维岛间距离、面积和形状不能单独证明真实组织距离、细胞数量或显著差异。
区分邻居图与 UMAP 坐标 · Python 可运行示例
分别检查图的维度、边权和二维坐标;两种对象回答不同问题。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 120 cells x 600 genes; not GSE135893
import numpy as np
import scanpy as sc
from anndata import AnnData
from importlib.metadata import version
rng = np.random.default_rng(104729)
counts = rng.poisson(np.linspace(0.2, 3, 600), size=(120, 600))
for k in range(3):
counts[k*40:(k+1)*40, 20+k*40:60+k*40] += 4
counts[:6, :12] += 20
adata = AnnData(counts.astype(float))
adata.var_names = [f"MT-{i+1}" if i < 12 else f"GENE{i+1}" for i in range(600)]
adata.obs_names = [f"cell{i+1}" for i in range(120)]
adata.obs["donor"] = [f"D{i % 4 + 1}" for i in range(120)]
adata.layers["counts"] = adata.X.copy()
assert adata.shape == (120, 600) and np.all(counts.sum(axis=1) > 0)
sc.pp.normalize_total(adata, target_sum=10000)
sc.pp.log1p(adata)
sc.pp.highly_variable_genes(adata, flavor="seurat_v3", n_top_genes=120, layer="counts")
work = adata[:, adata.var["highly_variable"]].copy()
sc.pp.scale(work, max_value=10)
sc.pp.pca(work, n_comps=10, svd_solver="arpack", random_state=104729)
sc.pp.neighbors(work, n_neighbors=15, n_pcs=10, metric="euclidean", random_state=104729)
sc.tl.umap(work, min_dist=0.3, random_state=104729)
graph = work.obsp["connectivities"]
xy = work.obsm["X_umap"]
print({"cells": graph.shape[0], "graph_nonzero": graph.nnz, "umap_dimensions": xy.shape[1]})
assert graph.shape == (120, 120) and xy.shape == (120, 2) and np.isfinite(xy).all()
print({p: version(p) for p in ("scanpy", "anndata", "numpy")})二维岛间距离、面积和形状不能单独证明真实组织距离、细胞数量或显著差异。
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持描述表达邻域和候选状态结构。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cell nodes; donor remains replication unit 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 FindNeighbors/sc.pp.neighbors 误差来源的测量,最能区分技术解释与生物解释?
批次与真实生物差异如何区分
QUESTION什么时候应该校正批次,怎样避免把疾病差异也一起抹掉?
INTUITION · 先建立直觉
像比较不同医院的检验结果:先确认仪器偏差,再校准;不能为了数值一致而消除真实患者差异。类比不是整合成功标准。
CLINICAL CASE · 肺纤维化情境
GSE135893 的 donor、取材与疾病状态可能部分相关;若条件与批次混杂,算法无法凭数据辨认两者。
WHY / PRINCIPLE
整合只应处理已识别的非生物变异;‘混得更均匀’不是成功,保留已知生物差异同样重要。
WORKFLOW · 数据怎样变化
- 01先画未整合数据
- 02检查 batch 与 condition 是否混杂
- 03选择校正协变量
- 04同时评估 batch removal 与 biology conservation
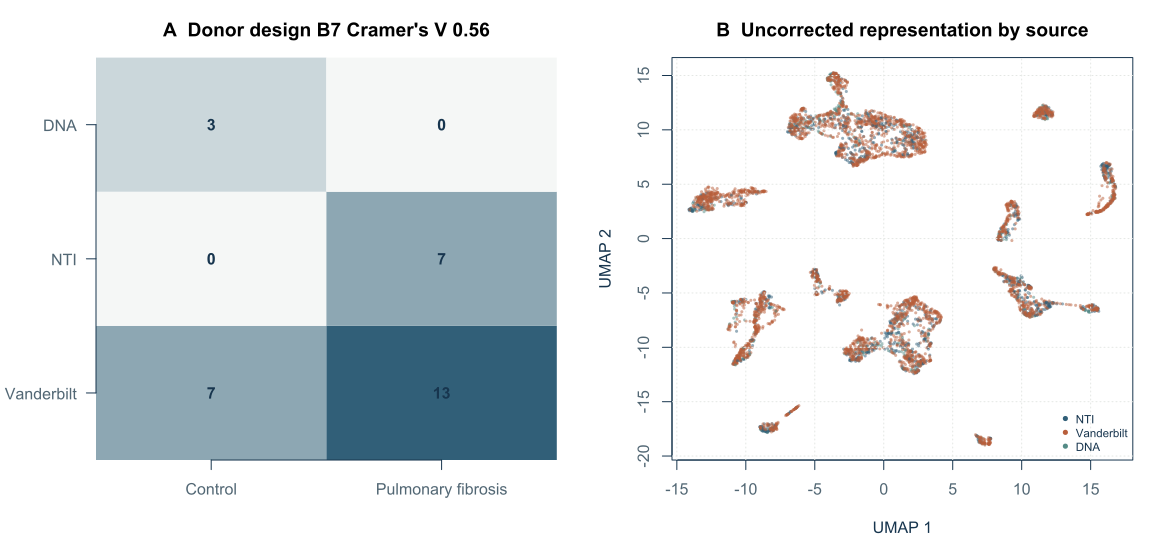
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · scripts/figures/scrna/generate-gse135893-foundations.R
- HASH
432f73c2d0f0…
逐项核对数值、适用条件与下一步
01before/after 使用同一细胞与编码需要情境化复核
Source × condition donor 设计表
在运行任何校正前,以 donor 为单位列联 Sample_Source 与 disease condition。
- 分子
- 各 source-condition donor count
- 分母
- 30 donors
- 统计单位
- donor
- 单位
- donors
30 donor design table
public metadata
- PASS每个关键 source 同时含两种 condition,目标效应可识别
- REVIEW部分 source 只含一组,但至少一个 source 有两组
- STOPsource 与 condition 完全一一对应
适用范围:Cramer's V 描述关联强度,不自动决定校正方法;先看具体空单元格。
联合因素:source · condition · donor
Cramer's V from donor-level contingency tableV=0.5635 且存在 3 个 source-condition 空/单组单元,说明部分混杂。
设计不是完全混杂,但 source 与 condition 关联较强,疾病解释必须做 within-source/敏感性分析。
02按 batch 看局部混合需要情境化复核
未校正表示中的 source 结构
在同一 PCA/UMAP 坐标按 sample source 着色,并用 kNN 同源率量化。
- 统计单位
- cell neighborhood; donor design
- 单位
- % and Cramer's V
uncorrected PCA k=15
donor-level design
- PASS同源率接近置换基线,且 donor 不形成独立岛
- REVIEW同源率高于基线但与 cell type 组成有关
- STOPsource 完全分离且与 condition 完全混杂
适用范围:必须在 cell type 内置换 source 标签建立基线。
联合因素:source · cell type · neighbor baseline
same-source neighbor fraction − within-cell-type permutation mean60.42% 没有基线时不能叫 batch effect;V=0.5635 提示设计层复核优先。
当前能发现风险,但尚未区分 source、cell type 组成与 disease 的贡献。
03按 cell type 看生物结构暂停解释
生物结构保留基线
在校正前记录已知 broad cell type 的邻域一致率,作为过度校正的对照。
- 统计单位
- cell neighborhood summarized by donor
- 单位
- % same-type neighbors
k=15 PCA neighbors
本章故意先停在可整合性审计
- PASS校正后 source mixing 改善,同时 same-type 与 marker 程序不显著下降
- REVIEWmixing 改善但稀有群/marker 减弱
- STOP不同谱系被强行混合或疾病程序消失
适用范围:未满足设计审计前不运行校正,因此 after 值缺失是正确停止状态。
联合因素:same-type neighbors · marker conservation · rare populations
Δbiology = metric_after − metric_before基线为 88.99%;没有 after 数据就不能声称 integration 成功。
当前只完成了整合前审计,不能伪造 before/after 改善。
04按 condition 看信号保留需要情境化复核
Disease signal conservation
对预定义疾病程序在校正前后用 donor-level effect、CI 与方向复核。
- 统计单位
- donor
- 单位
- effect size and 95% CI
需在校正前确定
10 control + 20 PF
- PASS预定义效应方向与量级保留,且不由 source 单独驱动
- REVIEW效应衰减 20–35% 或 within-source 方向不一致
- STOP校正后效应反号/消失,或只因目标颜色混合更均匀而接受
适用范围:20–35% 为课程敏感性区间;正式阈值须结合效应和测量误差预注册。
联合因素:donor effect · within-source estimate · CI
compare donor-level effect before/after and within Vanderbilt先注册 ECM/TGF-β program,再评估校正是否抹掉疾病差异。
尚未注册 disease program,不能进行无偏保留评估。
05复核 marker 与 donor 贡献需要情境化复核
是否进入整合的停止决策
综合设计表、source 邻域、biology baseline 与 disease conservation,决定校正、分层或不整合。
- 统计单位
- donor/design
- 单位
- decision
Cramer's V 0.5635
当前未运行校正
- PASS设计可识别且预设的 batch removal/biology conservation 双指标均通过
- REVIEW改为 within-source 主分析,跨 source 仅敏感性
- STOP完全混杂、稀有群消失或疾病效应无法区分
适用范围:本数据当前决策为 review,不是自动运行 Harmony/anchors。
联合因素:identifiability · batch removal · biology conservation
进入整合 = 设计可识别 AND 双目标指标预先定义V=0.5635 加上空单元格使 within-source 分析优先;‘混得均匀’不足以批准整合。
存在部分可识别信息,但跨 source 疾病效应仍有混杂风险。
先锁定 donor/batch for diagnostic; cells for representation,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
条件与批次完全重合、稀有群细胞数减少 >50%、同源率仍高于置换基线 z-score >3,或疾病程序 logFC 改变 ≥20% 时,不能宣称整合成功。
回到 按 donor/batch 标注的 normalized representations 定位冲突来自哪个独立单位,并用 Seurat anchors 的诊断输出复算;冲突未解释前只保留描述性结果。
支持减少已知技术来源对表示的影响。
不能从完全混合证明无批次效应,也不能恢复混杂设计中不可识别的条件效应。
VALIDATION · 下一层证据
- 留出至少一个 donor/batch for diagnostic; cells for representation 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R 分析调用片段
此片段承接本章数据对象;运行前先完成输入准备,不能作为独立脚本直接执行。
调用片段 · 需先准备下方输入对象
design <- unique(meta[c("Sample_Name", "Sample_Source", "Status")])
print(with(design, table(Sample_Source, Status)))
# 若 source 与 condition 混杂,算法不能识别地恢复 condition effect。
# 仅在设计可识别后,比较未校正与候选整合结果的 batch removal + biology conservation。Python 分析调用片段
此片段承接本章数据对象;运行前先完成输入准备,不能作为独立脚本直接执行。
调用片段 · 需先准备下方输入对象
design = adata.obs[["donor", "sample_source", "condition"]].drop_duplicates()
print(pd.crosstab(design.sample_source, design.condition))
# Do not integrate until the design table shows that the target effect is identifiable.TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持减少已知技术来源对表示的影响。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 donor/batch for diagnostic; cells for representation 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 Seurat anchors 误差来源的测量,最能区分技术解释与生物解释?
Part III · 识别细胞身份
从图社区到 marker 证据链,再用参考映射复核标签与置信度。
图结构如何形成 cluster
QUESTIONresolution 增加后出现的新群,是稳定亚群还是算法过度切分?
INTUITION · 先建立直觉
像把城市街区按道路连接划社区:比例尺越细社区越多,但每条街都命名成新区并不合理。类比不是聚类证据。
CLINICAL CASE · 肺纤维化情境
成纤维细胞在高 resolution 下分成多个亚群;需要同时检查来源父群、marker、donor 分布、QC 与稳定性。
WHY / PRINCIPLE
Leiden/Louvain 在图上优化社区结构;resolution 控制粒度,不代表生物学真值。
WORKFLOW · 数据怎样变化
- 01固定数据和邻居图
- 02比较相邻 resolution
- 03追踪父群到子群
- 04联合 marker、稳定性、QC、donor 后停止
Clustering 发生在图上,而不是在 UMAP 图片上
阶段 1 / 4:细胞点。 这些点暂时只是坐标:还不知道谁和谁相邻,也没有任何群组。
用预设的 12 个点、14 条边与 3 个群标签示意连接邻居、社区检测、赋予编号的步骤,不代表实际运行社区检测。跨群边淡化只为强调群结构,14 条边始终保留。
原创教学交互 · 模拟数据 · 未复制论文 Figure解释 neighbor graph 与社区检测如何产生 cluster,以及 cluster 编号与细胞身份之间的区别。
不能凭 cluster 的分离外观推断细胞类型的生物学真实性;身份判定需要 marker、参考与样本重复。
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R deterministic neighbor-graph teaching generator v1
- HASH
0ceb10104535…
逐项核对数值、适用条件与下一步
01Parent share通过快速筛查
指标 · Parent share
子群细胞数 / 父群细胞数
- 分子
- Parent share 的事件/阳性数量
- 分母
- 本项纳入的 cell communities checked across donors
- 统计单位
- cell communities checked across donors
- 单位
- %
固定种子教学摘要;parent cluster 3
可按脚本复算
- PASS184/264 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 clustering 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Parent share: 子群细胞数 / 父群细胞数; observed=184/264; compare=当前数据 P10–P90 与 leave-one-out.parent cluster 3 的教学值为 184/264;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Parent share 已给出观测值 184/264、单位 % 与统计范围 parent cluster 3;快速筛查通过,但仍需保留敏感性结果。
02Marker recurrence通过快速筛查
指标 · Marker recurrence
出现该 marker 集的 donor 数 / 可评估 donor 数
- 分子
- Marker recurrence 的事件/阳性数量
- 分母
- 本项纳入的 cell communities checked across donors
- 统计单位
- cell communities checked across donors
- 单位
- donors
固定种子教学摘要;COL1A1/COL3A1/DCN
可按脚本复算
- PASS5/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW5/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 clustering 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Marker recurrence: 出现该 marker 集的 donor 数 / 可评估 donor 数; observed=5/6; compare=当前数据 P10–P90 与 leave-one-out.COL1A1/COL3A1/DCN 的教学值为 5/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Marker recurrence 已给出观测值 5/6、单位 donors 与统计范围 COL1A1/COL3A1/DCN;快速筛查通过,但仍需保留敏感性结果。
03Neighbor Jaccard通过快速筛查
指标 · Neighbor Jaccard
相邻 resolution 的细胞邻域交集 / 并集
- 分子
- Neighbor Jaccard 的事件/阳性数量
- 分母
- 本项纳入的 cell communities checked across donors
- 统计单位
- cell communities checked across donors
- 单位
- Jaccard
固定种子教学摘要;same PCA graph
可按脚本复算
- PASSJaccard ≥0.80,并在 3 个固定种子/相邻参数中复现。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 clustering 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Neighbor Jaccard: 相邻 resolution 的细胞邻域交集 / 并集; observed=0.82; compare=Jaccard 0.80.same PCA graph 的教学值为 0.82;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Neighbor Jaccard 已给出观测值 0.82、单位 Jaccard 与统计范围 same PCA graph;快速筛查通过,但仍需保留敏感性结果。
04Sample coverage需要情境化复核
指标 · Sample coverage
贡献该子群的 donor 数 / 纳入 donor 数
- 分子
- Sample coverage 的事件/阳性数量
- 分母
- 本项纳入的 cell communities checked across donors
- 统计单位
- cell communities checked across donors
- 单位
- donors
固定种子教学摘要;cluster 3
可按脚本复算
- PASS6/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW6/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 clustering 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Sample coverage: 贡献该子群的 donor 数 / 纳入 donor 数; observed=6/6; compare=当前数据 P10–P90 与 leave-one-out.cluster 3 的教学值为 6/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Sample coverage 已给出观测值 6/6、单位 donors 与统计范围 cluster 3;需要补充 donor/模型诊断后再解释。
05Low-quality rate通过快速筛查
指标 · Low-quality rate
子群中 QC flag 细胞 / 子群细胞
- 分子
- Low-quality rate 的事件/阳性数量
- 分母
- 本项纳入的 cell communities checked across donors
- 统计单位
- cell communities checked across donors
- 单位
- %
固定种子教学摘要;nFeature/percent.mt flags
可按脚本复算
- PASS8/184 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 clustering 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Low-quality rate: 子群中 QC flag 细胞 / 子群细胞; observed=8/184; compare=当前数据 P10–P90 与 leave-one-out.nFeature/percent.mt flags 的教学值为 8/184;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Low-quality rate 已给出观测值 8/184、单位 % 与统计范围 nFeature/percent.mt flags;快速筛查通过,但仍需保留敏感性结果。
先锁定 cell communities checked across donors,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
新群由单 donor 贡献 >80%、marker 集阳性率 <50%、互斥 marker 冲突率 ≥20%,或仅在一个 resolution 出现时停止细分。
回到 固定 PCA neighbor graph 定位冲突来自哪个独立单位,并用 Leiden community detection 的诊断输出复算;冲突未解释前只保留描述性结果。
支持定义可进一步验证的表达社区。
不能仅凭 cluster 数证明存在同等数量的细胞类型。
VALIDATION · 下一层证据
- 留出至少一个 cell communities checked across donors 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
在固定邻居图上比较分辨率 · R 可运行示例
保持图不变,计算两套群标签,再用列联表查看哪些细胞被拆分或合并。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 600 genes x 120 cells; not GSE135893
library(Seurat)
set.seed(104729)
counts <- matrix(rpois(600 * 120, lambda = rep(seq(0.2, 3, length.out = 600), 120)), nrow = 600)
for (k in 0:2) counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] <- counts[(21 + 40*k):(60 + 40*k), (1 + 40*k):(40 + 40*k)] + 4L
counts[1:12, 1:6] <- counts[1:12, 1:6] + 20L
rownames(counts) <- c(paste0("MT-", 1:12), paste0("GENE", 13:600))
colnames(counts) <- paste0("cell", 1:120)
object <- CreateSeuratObject(counts = counts, min.cells = 0, min.features = 0)
object$donor <- rep(paste0("D", 1:4), length.out = 120)
stopifnot(all(dim(object) == c(600L, 120L)), all(colSums(counts) > 0))
object <- NormalizeData(object, normalization.method = "LogNormalize", scale.factor = 10000, verbose = FALSE)
object <- FindVariableFeatures(object, selection.method = "vst", nfeatures = 120, verbose = FALSE)
object <- ScaleData(object, features = VariableFeatures(object), verbose = FALSE)
object <- RunPCA(object, features = VariableFeatures(object), npcs = 10, seed.use = 104729, verbose = FALSE)
object <- FindNeighbors(object, reduction = "pca", dims = 1:10, k.param = 15, graph.name = c("lesson_nn", "lesson_snn"), verbose = FALSE)
for (r in c(0.5, 1.2)) {
object <- FindClusters(object, graph.name = "lesson_snn", algorithm = 4, resolution = r, random.seed = 104729, cluster.name = paste0("res_", r), verbose = FALSE)
}
print(table(object$res_0.5, object$res_1.2))
print(table(object$donor, object$res_1.2))
stopifnot(length(object$res_0.5) == 120L, !anyNA(object$res_1.2))
print(sessionInfo())Leiden 输出的是图社区,不能直接证明新细胞类型或疾病相关性。
在固定邻居图上比较分辨率 · Python 可运行示例
保持图不变,计算两套群标签,再用列联表查看哪些细胞被拆分或合并。
可运行教学示例 · 安装依赖后整段执行
# teaching-example: 120 cells x 600 genes; not GSE135893
import numpy as np
import scanpy as sc
from anndata import AnnData
from importlib.metadata import version
rng = np.random.default_rng(104729)
counts = rng.poisson(np.linspace(0.2, 3, 600), size=(120, 600))
for k in range(3):
counts[k*40:(k+1)*40, 20+k*40:60+k*40] += 4
counts[:6, :12] += 20
adata = AnnData(counts.astype(float))
adata.var_names = [f"MT-{i+1}" if i < 12 else f"GENE{i+1}" for i in range(600)]
adata.obs_names = [f"cell{i+1}" for i in range(120)]
adata.obs["donor"] = [f"D{i % 4 + 1}" for i in range(120)]
adata.layers["counts"] = adata.X.copy()
assert adata.shape == (120, 600) and np.all(counts.sum(axis=1) > 0)
sc.pp.normalize_total(adata, target_sum=10000)
sc.pp.log1p(adata)
sc.pp.highly_variable_genes(adata, flavor="seurat_v3", n_top_genes=120, layer="counts")
work = adata[:, adata.var["highly_variable"]].copy()
sc.pp.scale(work, max_value=10)
sc.pp.pca(work, n_comps=10, svd_solver="arpack", random_state=104729)
sc.pp.neighbors(work, n_neighbors=15, n_pcs=10, metric="euclidean", random_state=104729)
for r, key in [(0.5, "res_0.5"), (1.2, "res_1.2")]:
sc.tl.leiden(work, resolution=r, key_added=key, flavor="igraph", directed=False, n_iterations=2, random_state=104729)
import pandas as pd
print(pd.crosstab(work.obs["res_0.5"], work.obs["res_1.2"]))
print(pd.crosstab(work.obs["donor"], work.obs["res_1.2"]))
assert len(work.obs["res_0.5"]) == 120 and work.obs["res_1.2"].notna().all()
print({p: version(p) for p in ("scanpy", "anndata", "numpy")})Leiden 输出的是图社区,不能直接证明新细胞类型或疾病相关性。
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持定义可进一步验证的表达社区。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cell communities checked across donors 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 Leiden community detection 误差来源的测量,最能区分技术解释与生物解释?
marker 如何支持群体命名
QUESTION一个 cluster 的 marker 应如何从统计差异升级为细胞身份证据?
INTUITION · 先建立直觉
像身份核验要看一组相互一致的证件,不靠一个常见名字。类比不是注释证据。
CLINICAL CASE · 肺纤维化情境
COL1A1、COL3A1 与 DCN 共同支持基质程序;单独 COL1A1 也可能受 ambient RNA 或激活状态影响。
WHY / PRINCIPLE
marker 需要联合 logFC、pct.in/out、FDR、特异性与跨 donor 一致性,不能只看最小 P 值。
WORKFLOW · 数据怎样变化
- 01计算候选 marker
- 02同时看效应量和表达比例
- 03检查负 marker/互斥谱系
- 04按 donor 复核
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R deterministic neighbor-graph teaching generator v1
- HASH
0ceb10104535…
逐项核对数值、适用条件与下一步
01Effect size通过快速筛查
指标 · Effect size
cluster 内外平均表达差 / pooled SD
- 分子
- Effect size 的事件/阳性数量
- 分母
- 本项纳入的 cell for discovery, donor for reproducibility
- 统计单位
- cell for discovery, donor for reproducibility
- 单位
- standardized units
固定种子教学摘要;COL1A1
可按脚本复算
- PASS1.42 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 marker-genes 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Effect size: cluster 内外平均表达差 / pooled SD; observed=1.42; compare=当前数据 P10–P90 与 leave-one-out.COL1A1 的教学值为 1.42;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Effect size 已给出观测值 1.42、单位 standardized units 与统计范围 COL1A1;快速筛查通过,但仍需保留敏感性结果。
02Expression fraction通过快速筛查
指标 · Expression fraction
cluster 阳性细胞 / cluster 细胞
- 分子
- Expression fraction 的事件/阳性数量
- 分母
- 本项纳入的 cell for discovery, donor for reproducibility
- 统计单位
- cell for discovery, donor for reproducibility
- 单位
- %
固定种子教学摘要;COL1A1 > 0
可按脚本复算
- PASS162/184 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 marker-genes 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Expression fraction: cluster 阳性细胞 / cluster 细胞; observed=162/184; compare=当前数据 P10–P90 与 leave-one-out.COL1A1 > 0 的教学值为 162/184;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Expression fraction 已给出观测值 162/184、单位 % 与统计范围 COL1A1 > 0;快速筛查通过,但仍需保留敏感性结果。
03Specificity通过快速筛查
指标 · Specificity
pct.in − pct.out
- 分子
- Specificity 的事件/阳性数量
- 分母
- 本项纳入的 cell for discovery, donor for reproducibility
- 统计单位
- cell for discovery, donor for reproducibility
- 单位
- fraction
固定种子教学摘要;DCN
可按脚本复算
- PASS0.71 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 marker-genes 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Specificity: pct.in − pct.out; observed=0.71; compare=当前数据 P10–P90 与 leave-one-out.DCN 的教学值为 0.71;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Specificity 已给出观测值 0.71、单位 fraction 与统计范围 DCN;快速筛查通过,但仍需保留敏感性结果。
04Donor recurrence需要情境化复核
指标 · Donor recurrence
方向一致 donor / 可评估 donor
- 分子
- Donor recurrence 的事件/阳性数量
- 分母
- 本项纳入的 cell for discovery, donor for reproducibility
- 统计单位
- cell for discovery, donor for reproducibility
- 单位
- donors
固定种子教学摘要;COL3A1
可按脚本复算
- PASS5/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW5/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 marker-genes 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Donor recurrence: 方向一致 donor / 可评估 donor; observed=5/6; compare=当前数据 P10–P90 与 leave-one-out.COL3A1 的教学值为 5/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Donor recurrence 已给出观测值 5/6、单位 donors 与统计范围 COL3A1;需要补充 donor/模型诊断后再解释。
05FDR通过快速筛查
指标 · FDR
校正后的 marker 检验概率
- 分子
- FDR 的事件/阳性数量
- 分母
- 本项纳入的 cell for discovery, donor for reproducibility
- 统计单位
- cell for discovery, donor for reproducibility
- 单位
- 单位:FDR
固定种子教学摘要;Wilcoxon, gene-level
可按脚本复算
- PASSFDR ≤0.05,且检验对象、donor 数和多重校正方法预先登记。
- REVIEWFDR 在 0.05–0.10,或效应区间跨越零;只保留候选并补充独立样本。
- STOPFDR >0.10、效应区间跨零且 donor 方向不一致时停止强结论。
适用范围:数值仅绑定 marker-genes 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
FDR: 校正后的 marker 检验概率; observed=0.004; compare=FDR 0.05.Wilcoxon, gene-level 的教学值为 0.004;先按分子/分母计算,再检查 donor 覆盖和敏感性。
FDR 已给出观测值 0.004、单位 FDR 与统计范围 Wilcoxon, gene-level;快速筛查通过,但仍需保留敏感性结果。
先锁定 cell for discovery, donor for reproducibility,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
只靠 1 个 marker、阳性细胞 <20 个、复现 donor <3/4,或互斥 marker 冲突率 ≥20% 时停止命名。
回到 cluster labels、raw/normalized expression、donor 定位冲突来自哪个独立单位,并用 FindAllMarkers/rank_genes_groups 的诊断输出复算;冲突未解释前只保留描述性结果。
支持给 cluster 提出候选身份和状态。
不能单独证明细胞来源、功能或疾病作用。
VALIDATION · 下一层证据
- 留出至少一个 cell for discovery, donor for reproducibility 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- cluster labels、raw/normalized expression、donor;donor / condition metadata
- 预期输出
- 正负 marker、效应量与表达比例;可审计诊断摘要
- 计算候选 marker
- 同时看效应量和表达比例
- 检查负 marker/互斥谱系
- 按 donor 复核
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- cluster labels、raw/normalized expression、donor;donor / condition metadata
- 预期输出
- 正负 marker、效应量与表达比例;可审计诊断摘要
- 计算候选 marker
- 同时看效应量和表达比例
- 检查负 marker/互斥谱系
- 按 donor 复核
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持给 cluster 提出候选身份和状态。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cell for discovery, donor for reproducibility 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 FindAllMarkers/rank_genes_groups 误差来源的测量,最能区分技术解释与生物解释?
手工注释的证据链
QUESTION怎样把 cluster、marker、参考图谱和组织背景合并成带置信度的标签?
INTUITION · 先建立直觉
像临床诊断整合症状、检查、影像和流行病学背景;任何一项冲突都要降级置信度。类比不是诊断或注释证据。
CLINICAL CASE · 肺纤维化情境
Cluster 3 同时高表达 COL1A1/COL3A1/DCN,缺乏 EPCAM/PTPRC,并在多位 donor 中出现,可标注 Fibroblast。
WHY / PRINCIPLE
注释是多来源证据整合;标签粒度不得超过 marker 特异性、参考覆盖和样本支持。
WORKFLOW · 数据怎样变化
- 01确认谱系正/负 marker
- 02对照参考图谱
- 03加入组织与疾病背景
- 04检查 donor 分布与冲突
- 05按 High/Medium/Low 报告
Reference atlas
Known markers
Literature + tissue
注释是证据整合,不是自动命名。 单个 marker 可能共享表达或只反映瞬时状态。
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R deterministic neighbor-graph teaching generator v1
- HASH
0ceb10104535…
逐项核对数值、适用条件与下一步
01Positive marker set通过快速筛查
指标 · Positive marker set
同时满足预设 marker 的细胞 / cluster 细胞
- 分子
- Positive marker set 的事件/阳性数量
- 分母
- 本项纳入的 cluster/subcluster with donor-level support
- 统计单位
- cluster/subcluster with donor-level support
- 单位
- %
固定种子教学摘要;COL1A1+COL3A1+DCN
可按脚本复算
- PASS151/184 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 annotation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Positive marker set: 同时满足预设 marker 的细胞 / cluster 细胞; observed=151/184; compare=当前数据 P10–P90 与 leave-one-out.COL1A1+COL3A1+DCN 的教学值为 151/184;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Positive marker set 已给出观测值 151/184、单位 % 与统计范围 COL1A1+COL3A1+DCN;快速筛查通过,但仍需保留敏感性结果。
02Negative marker conflict通过快速筛查
指标 · Negative marker conflict
出现互斥谱系 marker 的细胞 / cluster 细胞
- 分子
- Negative marker conflict 的事件/阳性数量
- 分母
- 本项纳入的 cluster/subcluster with donor-level support
- 统计单位
- cluster/subcluster with donor-level support
- 单位
- %
固定种子教学摘要;EPCAM/PTPRC
可按脚本复算
- PASS3/184 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 annotation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Negative marker conflict: 出现互斥谱系 marker 的细胞 / cluster 细胞; observed=3/184; compare=当前数据 P10–P90 与 leave-one-out.EPCAM/PTPRC 的教学值为 3/184;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Negative marker conflict 已给出观测值 3/184、单位 % 与统计范围 EPCAM/PTPRC;快速筛查通过,但仍需保留敏感性结果。
03Reference agreement通过快速筛查
指标 · Reference agreement
两个参考库给出同一大谱系的细胞 / 映射细胞
- 分子
- Reference agreement 的事件/阳性数量
- 分母
- 本项纳入的 cluster/subcluster with donor-level support
- 统计单位
- cluster/subcluster with donor-level support
- 单位
- %
固定种子教学摘要;Azimuth + SingleR
可按脚本复算
- PASS164/184 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 annotation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Reference agreement: 两个参考库给出同一大谱系的细胞 / 映射细胞; observed=164/184; compare=当前数据 P10–P90 与 leave-one-out.Azimuth + SingleR 的教学值为 164/184;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Reference agreement 已给出观测值 164/184、单位 % 与统计范围 Azimuth + SingleR;快速筛查通过,但仍需保留敏感性结果。
04Donor coverage需要情境化复核
指标 · Donor coverage
出现该标签的 donor / 纳入 donor
- 分子
- Donor coverage 的事件/阳性数量
- 分母
- 本项纳入的 cluster/subcluster with donor-level support
- 统计单位
- cluster/subcluster with donor-level support
- 单位
- donors
固定种子教学摘要;Fibroblast candidate
可按脚本复算
- PASS6/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW6/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 annotation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Donor coverage: 出现该标签的 donor / 纳入 donor; observed=6/6; compare=当前数据 P10–P90 与 leave-one-out.Fibroblast candidate 的教学值为 6/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Donor coverage 已给出观测值 6/6、单位 donors 与统计范围 Fibroblast candidate;需要补充 donor/模型诊断后再解释。
05Score margin通过快速筛查
指标 · Score margin
top1 score − top2 score 的中位数
- 分子
- Score margin 的事件/阳性数量
- 分母
- 本项纳入的 cluster/subcluster with donor-level support
- 统计单位
- cluster/subcluster with donor-level support
- 单位
- score
固定种子教学摘要;cluster-level mapping
可按脚本复算
- PASS0.18 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 annotation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Score margin: top1 score − top2 score 的中位数; observed=0.18; compare=当前数据 P10–P90 与 leave-one-out.cluster-level mapping 的教学值为 0.18;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Score margin 已给出观测值 0.18、单位 score 与统计范围 cluster-level mapping;快速筛查通过,但仍需保留敏感性结果。
先锁定 cluster/subcluster with donor-level support,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
两种互斥谱系 marker 阳性率均 ≥0.20、top1−top2 <0.10、支持 donor <3/4,或群体 >80% 来自单 donor 时降低到宽泛标签。
回到 markers、reference atlas、文献、组织背景、sample composition 定位冲突来自哪个独立单位,并用 manual marker annotation 的诊断输出复算;冲突未解释前只保留描述性结果。
支持在当前参考与数据分辨率下赋予候选身份。
不能仅凭表达标签证明细胞功能、来源或稳定谱系。
VALIDATION · 下一层证据
- 留出至少一个 cluster/subcluster with donor-level support 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- markers、reference atlas、文献、组织背景、sample composition;donor / condition metadata
- 预期输出
- cell type/state label、confidence 与冲突记录;可审计诊断摘要
- 确认谱系正/负 marker
- 对照参考图谱
- 加入组织与疾病背景
- 检查 donor 分布与冲突
- 按 High/Medium/Low 报告
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- markers、reference atlas、文献、组织背景、sample composition;donor / condition metadata
- 预期输出
- cell type/state label、confidence 与冲突记录;可审计诊断摘要
- 确认谱系正/负 marker
- 对照参考图谱
- 加入组织与疾病背景
- 检查 donor 分布与冲突
- 按 High/Medium/Low 报告
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持在当前参考与数据分辨率下赋予候选身份。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cluster/subcluster with donor-level support 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 manual marker annotation 误差来源的测量,最能区分技术解释与生物解释?
自动注释与映射置信度
QUESTION参考图谱给出的标签何时可信,何时只是把未知状态硬塞进已知类别?
INTUITION · 先建立直觉
像用旧版地图导航新城区:高相似度能提示方向,但地图没有的道路不会自动被正确命名。类比不是映射证据。
CLINICAL CASE · 肺纤维化情境
纤维化特异成纤维状态可能在健康参考中缺失;自动映射仍会给出最近的已知标签。
WHY / PRINCIPLE
自动注释依赖参考覆盖、平台兼容和标签体系;置信度要与 marker 冲突和 out-of-reference 检测一起读。
WORKFLOW · 数据怎样变化
- 01选择组织匹配参考
- 02统一基因与表示
- 03映射并保留分数
- 04按 cluster/donor 复核 marker 与不确定性
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R deterministic neighbor-graph teaching generator v1
- HASH
0ceb10104535…
逐项核对数值、适用条件与下一步
01Top1–top2 margin通过快速筛查
指标 · Top1–top2 margin
第一与第二标签得分差
- 分子
- Top1–top2 margin 的事件/阳性数量
- 分母
- 本项纳入的 cell predictions summarized by cluster and donor
- 统计单位
- cell predictions summarized by cluster and donor
- 单位
- score
固定种子教学摘要;cluster median
可按脚本复算
- PASS0.18 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 reference-mapping 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Top1–top2 margin: 第一与第二标签得分差; observed=0.18; compare=当前数据 P10–P90 与 leave-one-out.cluster median 的教学值为 0.18;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Top1–top2 margin 已给出观测值 0.18、单位 score 与统计范围 cluster median;快速筛查通过,但仍需保留敏感性结果。
02Unmapped fraction通过快速筛查
指标 · Unmapped fraction
低于参考覆盖线的细胞 / query 细胞
- 分子
- Unmapped fraction 的事件/阳性数量
- 分母
- 本项纳入的 cell predictions summarized by cluster and donor
- 统计单位
- cell predictions summarized by cluster and donor
- 单位
- %
固定种子教学摘要;out-of-reference flag
可按脚本复算
- PASS21/480 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 reference-mapping 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Unmapped fraction: 低于参考覆盖线的细胞 / query 细胞; observed=21/480; compare=当前数据 P10–P90 与 leave-one-out.out-of-reference flag 的教学值为 21/480;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Unmapped fraction 已给出观测值 21/480、单位 % 与统计范围 out-of-reference flag;快速筛查通过,但仍需保留敏感性结果。
03Marker concordance通过快速筛查
指标 · Marker concordance
参考标签 marker 集阳性细胞 / query 细胞
- 分子
- Marker concordance 的事件/阳性数量
- 分母
- 本项纳入的 cell predictions summarized by cluster and donor
- 统计单位
- cell predictions summarized by cluster and donor
- 单位
- %
固定种子教学摘要;broad lineage
可按脚本复算
- PASS392/480 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 reference-mapping 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Marker concordance: 参考标签 marker 集阳性细胞 / query 细胞; observed=392/480; compare=当前数据 P10–P90 与 leave-one-out.broad lineage 的教学值为 392/480;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Marker concordance 已给出观测值 392/480、单位 % 与统计范围 broad lineage;快速筛查通过,但仍需保留敏感性结果。
04Reference overlap需要情境化复核
指标 · Reference overlap
两个参考库同意的细胞 / 两者均有预测细胞
- 分子
- Reference overlap 的事件/阳性数量
- 分母
- 本项纳入的 cell predictions summarized by cluster and donor
- 统计单位
- cell predictions summarized by cluster and donor
- 单位
- %
固定种子教学摘要;cross-reference
可按脚本复算
- PASS401/462 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 reference-mapping 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Reference overlap: 两个参考库同意的细胞 / 两者均有预测细胞; observed=401/462; compare=当前数据 P10–P90 与 leave-one-out.cross-reference 的教学值为 401/462;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Reference overlap 已给出观测值 401/462、单位 % 与统计范围 cross-reference;需要补充 donor/模型诊断后再解释。
05Donor recurrence通过快速筛查
指标 · Donor recurrence
同一标签在 donor 中出现的数量
- 分子
- Donor recurrence 的事件/阳性数量
- 分母
- 本项纳入的 cell predictions summarized by cluster and donor
- 统计单位
- cell predictions summarized by cluster and donor
- 单位
- donors
固定种子教学摘要;unknown excluded
可按脚本复算
- PASS6/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW6/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 reference-mapping 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Donor recurrence: 同一标签在 donor 中出现的数量; observed=6/6; compare=当前数据 P10–P90 与 leave-one-out.unknown excluded 的教学值为 6/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Donor recurrence 已给出观测值 6/6、单位 donors 与统计范围 unknown excluded;快速筛查通过,但仍需保留敏感性结果。
先锁定 cell predictions summarized by cluster and donor,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
所有细胞被强制分配、置信度普遍低或疾病特异群与参考冲突时保留 unknown。
回到 query expression、reference labels/embedding 定位冲突来自哪个独立单位,并用 Azimuth/Seurat mapping 的诊断输出复算;冲突未解释前只保留描述性结果。
支持标准化标签并发现需要人工复核的区域。
不能证明参考标签就是新数据中的真实生物身份。
VALIDATION · 下一层证据
- 留出至少一个 cell predictions summarized by cluster and donor 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- query expression、reference labels/embedding;donor / condition metadata
- 预期输出
- predicted label、score、unmapped/uncertain flag;可审计诊断摘要
- 选择组织匹配参考
- 统一基因与表示
- 映射并保留分数
- 按 cluster/donor 复核 marker 与不确定性
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- query expression、reference labels/embedding;donor / condition metadata
- 预期输出
- predicted label、score、unmapped/uncertain flag;可审计诊断摘要
- 选择组织匹配参考
- 统一基因与表示
- 映射并保留分数
- 按 cluster/donor 复核 marker 与不确定性
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持标准化标签并发现需要人工复核的区域。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cell predictions summarized by cluster and donor 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 Azimuth/Seurat mapping 误差来源的测量,最能区分技术解释与生物解释?
Part IV · 比较细胞状态
把患者而不是细胞作为统计重复,比较表达、组成和通路变化。
为什么患者比较不能把细胞当重复
QUESTION疾病与对照差异应该以细胞还是供体作为独立重复?
INTUITION · 先建立直觉
同一患者做一千次测量仍不是一千位患者;细胞是嵌套观察,供体才是疾病比较的独立单位。类比对应实验设计而不是统计证明。
CLINICAL CASE · 肺纤维化情境
比较 IPF 与对照成纤维细胞时,把每个细胞作为独立样本会产生虚假精确度;应按 donor×cell type 汇总 counts。
WHY / PRINCIPLE
pseudobulk 保留生物重复与 count model;细胞数影响精度但不增加独立患者数。
WORKFLOW · 数据怎样变化
- 01按 donor×cell type 汇总 raw counts
- 02过滤低细胞/低计数样本
- 03建立含 condition/协变量的模型
- 04报告效应量、FDR 与 donor 分布
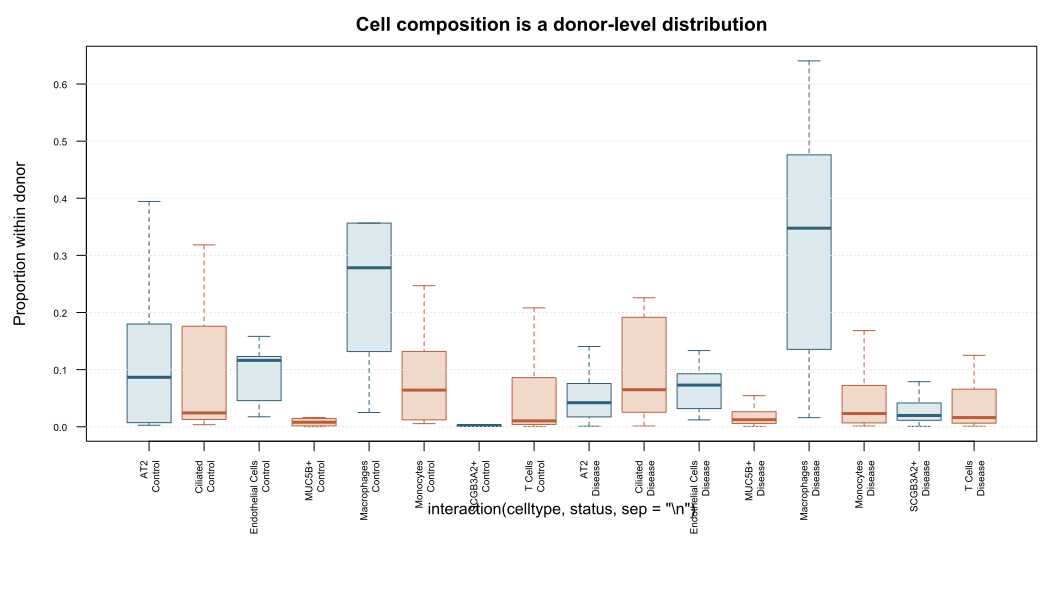
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · donor-level composition from public metadata
- HASH
a5ec477bb39f…
逐项核对数值、适用条件与下一步
01Donor count通过快速筛查
指标 · Donor count
有效 donor / 设计中的 donor
- 分子
- Donor count 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- donors
固定种子教学摘要;fibroblast: IPF vs control
可按脚本复算
- PASS7/10;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW7/10 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 pseudobulk-de 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Donor count: 有效 donor / 设计中的 donor; observed=7/10; compare=当前数据 P10–P90 与 leave-one-out.fibroblast: IPF vs control 的教学值为 7/10;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Donor count 已给出观测值 7/10、单位 donors 与统计范围 fibroblast: IPF vs control;快速筛查通过,但仍需保留敏感性结果。
02Effect size通过快速筛查
指标 · Effect size
log2(IPF/control) pseudobulk
- 分子
- Effect size 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- log2 fold-change
固定种子教学摘要;COL1A1
可按脚本复算
- PASS1.18 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 pseudobulk-de 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Effect size: log2(IPF/control) pseudobulk; observed=1.18; compare=当前数据 P10–P90 与 leave-one-out.COL1A1 的教学值为 1.18;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Effect size 已给出观测值 1.18、单位 log2 fold-change 与统计范围 COL1A1;快速筛查通过,但仍需保留敏感性结果。
0395% CI通过快速筛查
指标 · 95% CI
donor-level model 的置信区间
- 分子
- 95% CI 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- log2 fold-change
固定种子教学摘要;DESeq2 Wald CI
可按脚本复算
- PASS0.62–1.74 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 pseudobulk-de 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
95% CI: donor-level model 的置信区间; observed=0.62–1.74; compare=当前数据 P10–P90 与 leave-one-out.DESeq2 Wald CI 的教学值为 0.62–1.74;先按分子/分母计算,再检查 donor 覆盖和敏感性。
95% CI 已给出观测值 0.62–1.74、单位 log2 fold-change 与统计范围 DESeq2 Wald CI;快速筛查通过,但仍需保留敏感性结果。
04FDR需要情境化复核
指标 · FDR
多重校正后的 donor-level P 值
- 分子
- FDR 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- 单位:FDR
固定种子教学摘要;Benjamini–Hochberg
可按脚本复算
- PASSFDR ≤0.05,且检验对象、donor 数和多重校正方法预先登记。
- REVIEWFDR 在 0.05–0.10,或效应区间跨越零;只保留候选并补充独立样本。
- STOPFDR >0.10、效应区间跨零且 donor 方向不一致时停止强结论。
适用范围:数值仅绑定 pseudobulk-de 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
FDR: 多重校正后的 donor-level P 值; observed=0.003; compare=FDR 0.05.Benjamini–Hochberg 的教学值为 0.003;先按分子/分母计算,再检查 donor 覆盖和敏感性。
FDR 已给出观测值 0.003、单位 FDR 与统计范围 Benjamini–Hochberg;需要补充 donor/模型诊断后再解释。
05Leave-one-donor-out通过快速筛查
指标 · Leave-one-donor-out
剔除一个 donor 后效应方向保持的模型数 / donor 数
- 分子
- Leave-one-donor-out 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- models
固定种子教学摘要;sensitivity
可按脚本复算
- PASS8/10;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW8/10 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 pseudobulk-de 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Leave-one-donor-out: 剔除一个 donor 后效应方向保持的模型数 / donor 数; observed=8/10; compare=当前数据 P10–P90 与 leave-one-out.sensitivity 的教学值为 8/10;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Leave-one-donor-out 已给出观测值 8/10、单位 models 与统计范围 sensitivity;快速筛查通过,但仍需保留敏感性结果。
先锁定 donor,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
cells-as-replicates、每组 donor 过少、条件与批次混杂或单 donor 决定效应时停止强结论。
回到 raw counts、donor、condition、cell type 定位冲突来自哪个独立单位,并用 edgeR/DESeq2 pseudobulk 的诊断输出复算;冲突未解释前只保留描述性结果。
支持某细胞类型中疾病相关的群体平均表达差异。
不能单独证明差异基因导致疾病或在每个细胞都改变。
VALIDATION · 下一层证据
- 留出至少一个 donor 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- raw counts、donor、condition、cell type;donor / condition metadata
- 预期输出
- donor-level pseudobulk counts、logFC、FDR;可审计诊断摘要
- 按 donor×cell type 汇总 raw counts
- 过滤低细胞/低计数样本
- 建立含 condition/协变量的模型
- 报告效应量、FDR 与 donor 分布
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- raw counts、donor、condition、cell type;donor / condition metadata
- 预期输出
- donor-level pseudobulk counts、logFC、FDR;可审计诊断摘要
- 按 donor×cell type 汇总 raw counts
- 过滤低细胞/低计数样本
- 建立含 condition/协变量的模型
- 报告效应量、FDR 与 donor 分布
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持某细胞类型中疾病相关的群体平均表达差异。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 donor 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 edgeR/DESeq2 pseudobulk 误差来源的测量,最能区分技术解释与生物解释?
比例变化为什么可能误导
QUESTION某细胞群比例升高,意味着绝对细胞数增加,还是其他群减少或取样发生变化?
INTUITION · 先建立直觉
一块固定大小的饼中某一块变大,可能因为它增加,也可能因为别的块缩小;比例受到总和为 100% 的约束。类比不是组成模型。
CLINICAL CASE · 肺纤维化情境
GSE135893 中每位 donor 的细胞类型比例不同;需要以 donor 分布比较,而不是把所有细胞合并成两根柱。
WHY / PRINCIPLE
组成数据具有闭合约束;解离、捕获与过滤会改变分母,比例差异不等于组织绝对丰度。
WORKFLOW · 数据怎样变化
- 01按 donor 计数
- 02展示每位 donor 而非仅均值
- 03检查绝对计数/取样过程
- 04使用组成或计数模型
- 05做过滤敏感性分析
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · donor-level composition from public metadata
- HASH
a5ec477bb39f…
逐项核对数值、适用条件与下一步
01Composition denominator通过快速筛查
指标 · Composition denominator
某 cell type / 样本中全部 called cells
- 分子
- Composition denominator 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- %
固定种子教学摘要;donor 04
可按脚本复算
- PASS420/2,100 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-composition 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Composition denominator: 某 cell type / 样本中全部 called cells; observed=420/2,100; compare=当前数据 P10–P90 与 leave-one-out.donor 04 的教学值为 420/2,100;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Composition denominator 已给出观测值 420/2,100、单位 % 与统计范围 donor 04;快速筛查通过,但仍需保留敏感性结果。
02Donor direction通过快速筛查
指标 · Donor direction
比例变化同方向 donor / 可评估 donor
- 分子
- Donor direction 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- donors
固定种子教学摘要;Fibroblast proportion
可按脚本复算
- PASS6/8;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW6/8 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-composition 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Donor direction: 比例变化同方向 donor / 可评估 donor; observed=6/8; compare=当前数据 P10–P90 与 leave-one-out.Fibroblast proportion 的教学值为 6/8;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Donor direction 已给出观测值 6/8、单位 donors 与统计范围 Fibroblast proportion;快速筛查通过,但仍需保留敏感性结果。
03Absolute count通过快速筛查
指标 · Absolute count
目标细胞数 / 组织输入量
- 分子
- Absolute count 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- cells per 10k input
固定种子教学摘要;donor 04
可按脚本复算
- PASS420/10,000 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-composition 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Absolute count: 目标细胞数 / 组织输入量; observed=420/10,000; compare=当前数据 P10–P90 与 leave-one-out.donor 04 的教学值为 420/10,000;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Absolute count 已给出观测值 420/10,000、单位 cells per 10k input 与统计范围 donor 04;快速筛查通过,但仍需保留敏感性结果。
04Sampling sensitivity需要情境化复核
指标 · Sampling sensitivity
不同下采样重复中方向保持次数 / 重复次数
- 分子
- Sampling sensitivity 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- resamples
固定种子教学摘要;fixed depth
可按脚本复算
- PASS18/20;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW18/20 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-composition 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Sampling sensitivity: 不同下采样重复中方向保持次数 / 重复次数; observed=18/20; compare=当前数据 P10–P90 与 leave-one-out.fixed depth 的教学值为 18/20;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Sampling sensitivity 已给出观测值 18/20、单位 resamples 与统计范围 fixed depth;需要补充 donor/模型诊断后再解释。
05Compositional balance通过快速筛查
指标 · Compositional balance
其他 major cell types 比例总和 + target proportion
- 分子
- Compositional balance 的事件/阳性数量
- 分母
- 本项纳入的 donor
- 统计单位
- donor
- 单位
- fraction
固定种子教学摘要;per donor
可按脚本复算
- PASS1.000 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-composition 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Compositional balance: 其他 major cell types 比例总和 + target proportion; observed=1.000; compare=当前数据 P10–P90 与 leave-one-out.per donor 的教学值为 1.000;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Compositional balance 已给出观测值 1.000、单位 fraction 与统计范围 per donor;快速筛查通过,但仍需保留敏感性结果。
先锁定 donor,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
只有合并比例、样本细胞数极不均、解离偏差不明或差异由一个 donor 驱动时暂停。
回到 cell labels、donor、condition、每样本细胞数与取样信息 定位冲突来自哪个独立单位,并用 donor-level proportion model 的诊断输出复算;冲突未解释前只保留描述性结果。
支持疾病组中捕获到的细胞组成发生关联性变化。
不能单独证明组织内真实绝对细胞数或迁移/增殖机制。
VALIDATION · 下一层证据
- 留出至少一个 donor 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- cell labels、donor、condition、每样本细胞数与取样信息;donor / condition metadata
- 预期输出
- donor-level proportions、uncertainty 与敏感性结果;可审计诊断摘要
- 按 donor 计数
- 展示每位 donor 而非仅均值
- 检查绝对计数/取样过程
- 使用组成或计数模型
- 做过滤敏感性分析
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- cell labels、donor、condition、每样本细胞数与取样信息;donor / condition metadata
- 预期输出
- donor-level proportions、uncertainty 与敏感性结果;可审计诊断摘要
- 按 donor 计数
- 展示每位 donor 而非仅均值
- 检查绝对计数/取样过程
- 使用组成或计数模型
- 做过滤敏感性分析
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持疾病组中捕获到的细胞组成发生关联性变化。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 donor 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 donor-level proportion model 误差来源的测量,最能区分技术解释与生物解释?
基因变化如何成为功能假设
QUESTION如何把排序基因表转成协调变化的生物过程,而不把数据库名称当机制?
INTUITION · 先建立直觉
像根据整支球队多个球员的变化判断战术趋势,而不是只看一个明星球员。类比不是通路活性测量。
CLINICAL CASE · 肺纤维化情境
IPF 成纤维细胞的 ECM、TGF-β 或炎症基因集可能富集;需要看 leading edge、donor 稳定性和基因集重叠。
WHY / PRINCIPLE
GSEA 检验基因集在排序两端的协调富集;结果依赖排名统计量、背景集合与数据库冗余。
WORKFLOW · 数据怎样变化
- 01建立不截断的基因排序
- 02选择版本化 gene sets
- 03运行富集与多重校正
- 04查看 leading edge 与冗余
- 05跨 donor/方法验证
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · donor-level composition from public metadata
- HASH
a5ec477bb39f…
逐项核对数值、适用条件与下一步
01Gene-set size通过快速筛查
指标 · Gene-set size
进入通路检验的有效基因数
- 分子
- Gene-set size 的事件/阳性数量
- 分母
- 本项纳入的 gene ranking derived from donor-level model
- 统计单位
- gene ranking derived from donor-level model
- 单位
- genes
固定种子教学摘要;TGF-beta set
可按脚本复算
- PASS86 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 pathway-analysis 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Gene-set size: 进入通路检验的有效基因数; observed=86; compare=当前数据 P10–P90 与 leave-one-out.TGF-beta set 的教学值为 86;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Gene-set size 已给出观测值 86、单位 genes 与统计范围 TGF-beta set;快速筛查通过,但仍需保留敏感性结果。
02Leading-edge recurrence通过快速筛查
指标 · Leading-edge recurrence
核心 leading-edge 基因在 donor 中复现数 / donor 数
- 分子
- Leading-edge recurrence 的事件/阳性数量
- 分母
- 本项纳入的 gene ranking derived from donor-level model
- 统计单位
- gene ranking derived from donor-level model
- 单位
- donors
固定种子教学摘要;TGFBR1/SMAD3/COL1A1
可按脚本复算
- PASS5/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW5/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 pathway-analysis 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Leading-edge recurrence: 核心 leading-edge 基因在 donor 中复现数 / donor 数; observed=5/6; compare=当前数据 P10–P90 与 leave-one-out.TGFBR1/SMAD3/COL1A1 的教学值为 5/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Leading-edge recurrence 已给出观测值 5/6、单位 donors 与统计范围 TGFBR1/SMAD3/COL1A1;快速筛查通过,但仍需保留敏感性结果。
03NES通过快速筛查
指标 · NES
置换归一化富集分数
- 分子
- NES 的事件/阳性数量
- 分母
- 本项纳入的 gene ranking derived from donor-level model
- 统计单位
- gene ranking derived from donor-level model
- 单位
- 单位:NES
固定种子教学摘要;fgsea
可按脚本复算
- PASS2.31 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 pathway-analysis 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
NES: 置换归一化富集分数; observed=2.31; compare=当前数据 P10–P90 与 leave-one-out.fgsea 的教学值为 2.31;先按分子/分母计算,再检查 donor 覆盖和敏感性。
NES 已给出观测值 2.31、单位 NES 与统计范围 fgsea;快速筛查通过,但仍需保留敏感性结果。
04FDR需要情境化复核
指标 · FDR
通路级多重校正概率
- 分子
- FDR 的事件/阳性数量
- 分母
- 本项纳入的 gene ranking derived from donor-level model
- 统计单位
- gene ranking derived from donor-level model
- 单位
- 单位:FDR
固定种子教学摘要;1,000 permutations
可按脚本复算
- PASSFDR ≤0.05,且检验对象、donor 数和多重校正方法预先登记。
- REVIEWFDR 在 0.05–0.10,或效应区间跨越零;只保留候选并补充独立样本。
- STOPFDR >0.10、效应区间跨零且 donor 方向不一致时停止强结论。
适用范围:数值仅绑定 pathway-analysis 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
FDR: 通路级多重校正概率; observed=0.012; compare=FDR 0.05.1,000 permutations 的教学值为 0.012;先按分子/分母计算,再检查 donor 覆盖和敏感性。
FDR 已给出观测值 0.012、单位 FDR 与统计范围 1,000 permutations;需要补充 donor/模型诊断后再解释。
05Direction sensitivity通过快速筛查
指标 · Direction sensitivity
留一 donor 后 NES 仍为正的模型 / donor 数
- 分子
- Direction sensitivity 的事件/阳性数量
- 分母
- 本项纳入的 gene ranking derived from donor-level model
- 统计单位
- gene ranking derived from donor-level model
- 单位
- models
固定种子教学摘要;leave-one-donor-out
可按脚本复算
- PASS5/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW5/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 pathway-analysis 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Direction sensitivity: 留一 donor 后 NES 仍为正的模型 / donor 数; observed=5/6; compare=当前数据 P10–P90 与 leave-one-out.leave-one-donor-out 的教学值为 5/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Direction sensitivity 已给出观测值 5/6、单位 models 与统计范围 leave-one-donor-out;快速筛查通过,但仍需保留敏感性结果。
先锁定 gene ranking derived from donor-level model,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
通路由单个基因驱动、基因集高度重叠、排名来自 cells-as-replicates 或 FDR 不稳定时暂停机制解释。
回到 donor-aware DE 排名、预定义 gene sets 定位冲突来自哪个独立单位,并用 fgsea/clusterProfiler 的诊断输出复算;冲突未解释前只保留描述性结果。
支持某功能程序在疾病相关排序中富集。
不能单独证明通路被激活、蛋白活性改变或该通路导致疾病。
VALIDATION · 下一层证据
- 留出至少一个 gene ranking derived from donor-level model 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- donor-aware DE 排名、预定义 gene sets;donor / condition metadata
- 预期输出
- NES、FDR、leading-edge genes 与候选功能假设;可审计诊断摘要
- 建立不截断的基因排序
- 选择版本化 gene sets
- 运行富集与多重校正
- 查看 leading edge 与冗余
- 跨 donor/方法验证
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- donor-aware DE 排名、预定义 gene sets;donor / condition metadata
- 预期输出
- NES、FDR、leading-edge genes 与候选功能假设;可审计诊断摘要
- 建立不截断的基因排序
- 选择版本化 gene sets
- 运行富集与多重校正
- 查看 leading edge 与冗余
- 跨 donor/方法验证
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持某功能程序在疾病相关排序中富集。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 gene ranking derived from donor-level model 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 fgsea/clusterProfiler 误差来源的测量,最能区分技术解释与生物解释?
Part V · 动态与调控推断
学习轨迹、速度、命运、调控网络与通讯模型各自需要的数据层和证据边界。
Pseudotime ≠ Real Time
QUESTION静态快照中的细胞能否被排列为一个候选连续过程?
INTUITION · 先建立直觉
像根据不同年龄照片重建成长顺序:能得到合理排列,但没有拍到同一个人随时间变化。类比不是时间证据。
CLINICAL CASE · 肺纤维化情境
成纤维细胞从稳态到活化的连续表达状态可被排序,但根节点选择和样本覆盖会改变方向。
WHY / PRINCIPLE
轨迹算法在状态流形上拟合顺序;方向来自先验/root 或模型,静态数据不包含真实时间。
WORKFLOW · 数据怎样变化
- 01限定生物学谱系
- 02检查连续覆盖
- 03选择并论证 root
- 04比较算法/参数
- 05按 donor 与动态基因验证
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R deterministic neighbor-graph teaching generator v1
- HASH
0ceb10104535…
逐项核对数值、适用条件与下一步
01Root reachability通过快速筛查
指标 · Root reachability
可从预设起点到达的细胞 / 轨迹细胞
- 分子
- Root reachability 的事件/阳性数量
- 分母
- 本项纳入的 cell ordering; reproducibility checked across donors
- 统计单位
- cell ordering; reproducibility checked across donors
- 单位
- %
固定种子教学摘要;epithelial→mesenchymal
可按脚本复算
- PASS1,124/1,480 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 pseudotime 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Root reachability: 可从预设起点到达的细胞 / 轨迹细胞; observed=1,124/1,480; compare=当前数据 P10–P90 与 leave-one-out.epithelial→mesenchymal 的教学值为 1,124/1,480;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Root reachability 已给出观测值 1,124/1,480、单位 % 与统计范围 epithelial→mesenchymal;快速筛查通过,但仍需保留敏感性结果。
02Ordering stability通过快速筛查
指标 · Ordering stability
重采样后 pseudotime 相关系数中位数
- 分子
- Ordering stability 的事件/阳性数量
- 分母
- 本项纳入的 cell ordering; reproducibility checked across donors
- 统计单位
- cell ordering; reproducibility checked across donors
- 单位
- Spearman ρ
固定种子教学摘要;20 resamples
可按脚本复算
- PASS0.87 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 pseudotime 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Ordering stability: 重采样后 pseudotime 相关系数中位数; observed=0.87; compare=当前数据 P10–P90 与 leave-one-out.20 resamples 的教学值为 0.87;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Ordering stability 已给出观测值 0.87、单位 Spearman ρ 与统计范围 20 resamples;快速筛查通过,但仍需保留敏感性结果。
03Branch support通过快速筛查
指标 · Branch support
分支中有≥3 donor 的分支 / 总分支
- 分子
- Branch support 的事件/阳性数量
- 分母
- 本项纳入的 cell ordering; reproducibility checked across donors
- 统计单位
- cell ordering; reproducibility checked across donors
- 单位
- branches
固定种子教学摘要;donor coverage
可按脚本复算
- PASS3/4;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW3/4 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 pseudotime 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Branch support: 分支中有≥3 donor 的分支 / 总分支; observed=3/4; compare=当前数据 P10–P90 与 leave-one-out.donor coverage 的教学值为 3/4;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Branch support 已给出观测值 3/4、单位 branches 与统计范围 donor coverage;快速筛查通过,但仍需保留敏感性结果。
04Gene trend fit需要情境化复核
指标 · Gene trend fit
拟合非线性趋势 FDR <0.05 的基因 / tested genes
- 分子
- Gene trend fit 的事件/阳性数量
- 分母
- 本项纳入的 cell ordering; reproducibility checked across donors
- 统计单位
- cell ordering; reproducibility checked across donors
- 单位
- genes
固定种子教学摘要;GAM
可按脚本复算
- PASSFDR ≤0.05,且检验对象、donor 数和多重校正方法预先登记。
- REVIEWFDR 在 0.05–0.10,或效应区间跨越零;只保留候选并补充独立样本。
- STOPFDR >0.10、效应区间跨零且 donor 方向不一致时停止强结论。
适用范围:数值仅绑定 pseudotime 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Gene trend fit: 拟合非线性趋势 FDR <0.05 的基因 / tested genes; observed=42/180; compare=FDR 0.05.GAM 的教学值为 42/180;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Gene trend fit 已给出观测值 42/180、单位 genes 与统计范围 GAM;需要补充 donor/模型诊断后再解释。
05Real-time evidence需要情境化复核
指标 · Real-time evidence
实际时间点信息是否存在
- 分子
- Real-time evidence 的事件/阳性数量
- 分母
- 本项纳入的 cell ordering; reproducibility checked across donors
- 统计单位
- cell ordering; reproducibility checked across donors
- 单位
- not measured
固定种子教学摘要;pseudotime only
原始对象未提供,不能替换为经验阈值
- PASS资料可用后再判断;当前不能把缺失数据当作通过。
- REVIEW输入层缺失;显示 unavailable,不输出数值结论。
- STOP数据对象不存在或统计单位不匹配时停止下游解释。
适用范围:数值仅绑定 pseudotime 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Real-time evidence: 实际时间点信息是否存在; observed=unavailable; compare=当前数据 P10–P90 与 leave-one-out.pseudotime only 的教学值为 unavailable;由于没有输入对象,页面明确标记 unavailable,不能输出通过结论。
Real-time evidence 的原始输入缺失;当前只能说明缺口,不能以“合理”或“稳定”代替计算。
先锁定 cell ordering; reproducibility checked across donors,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
曲线跨空白、轨迹等同 batch/cell cycle、单 donor 覆盖一端或换 root 后结论反转时停止。
回到 选定谱系细胞、neighbor graph/embedding、root 定位冲突来自哪个独立单位,并用 Slingshot/Monocle 的诊断输出复算;冲突未解释前只保留描述性结果。
支持候选细胞状态的相对排序和分支假设。
不能证明真实时间、谱系祖先关系或不可逆命运。
VALIDATION · 下一层证据
- 留出至少一个 cell ordering; reproducibility checked across donors 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- 选定谱系细胞、neighbor graph/embedding、root;donor / condition metadata
- 预期输出
- pseudotime、branches 与动态基因;可审计诊断摘要
- 限定生物学谱系
- 检查连续覆盖
- 选择并论证 root
- 比较算法/参数
- 按 donor 与动态基因验证
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- 选定谱系细胞、neighbor graph/embedding、root;donor / condition metadata
- 预期输出
- pseudotime、branches 与动态基因;可审计诊断摘要
- 限定生物学谱系
- 检查连续覆盖
- 选择并论证 root
- 比较算法/参数
- 按 donor 与动态基因验证
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持候选细胞状态的相对排序和分支假设。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cell ordering; reproducibility checked across donors 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 Slingshot/Monocle 误差来源的测量,最能区分技术解释与生物解释?
RNA Velocity 的箭头意味着什么
QUESTIONspliced 与 unspliced RNA 的比例能否提示近期转录状态变化方向?
INTUITION · 先建立直觉
像同时观察已发出的列车和站台上正在上车的人,可能提示短期流向,但不是完整旅程记录。类比不是动力学证据。
CLINICAL CASE · 肺纤维化情境
GSE135893 轻量对象没有 spliced/unspliced layers,因此本章改用公开胰腺辅助数据;它不是肺纤维化证据。
WHY / PRINCIPLE
Velocity 依赖剪接动力学假设和足够的 layer 质量;箭头是模型估计,不是细胞追踪。
WORKFLOW · 数据怎样变化
- 01验证 layers 与基因覆盖
- 02预处理 moments
- 03拟合稳态或动态模型
- 04查看 gene-level phase portraits
- 05比较方向与已知谱系
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R deterministic neighbor-graph teaching generator v1
- HASH
0ceb10104535…
逐项核对数值、适用条件与下一步
01Spliced layer通过快速筛查
指标 · Spliced layer
存在 spliced 与 unspliced 的细胞 / 总细胞
- 分子
- Spliced layer 的事件/阳性数量
- 分母
- 本项纳入的 cell dynamics checked across genes and samples
- 统计单位
- cell dynamics checked across genes and samples
- 单位
- %
固定种子教学摘要;velocity input
可按脚本复算
- PASS3,180/3,200 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 rna-velocity 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Spliced layer: 存在 spliced 与 unspliced 的细胞 / 总细胞; observed=3,180/3,200; compare=当前数据 P10–P90 与 leave-one-out.velocity input 的教学值为 3,180/3,200;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Spliced layer 已给出观测值 3,180/3,200、单位 % 与统计范围 velocity input;快速筛查通过,但仍需保留敏感性结果。
02Velocity confidence通过快速筛查
指标 · Velocity confidence
达到模型置信线的细胞 / velocity cells
- 分子
- Velocity confidence 的事件/阳性数量
- 分母
- 本项纳入的 cell dynamics checked across genes and samples
- 统计单位
- cell dynamics checked across genes and samples
- 单位
- %
固定种子教学摘要;scVelo dynamical
可按脚本复算
- PASS2,412/3,180 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 rna-velocity 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Velocity confidence: 达到模型置信线的细胞 / velocity cells; observed=2,412/3,180; compare=当前数据 P10–P90 与 leave-one-out.scVelo dynamical 的教学值为 2,412/3,180;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Velocity confidence 已给出观测值 2,412/3,180、单位 % 与统计范围 scVelo dynamical;快速筛查通过,但仍需保留敏感性结果。
03Direction reproducibility通过快速筛查
指标 · Direction reproducibility
bootstrap 后方向相同 donor / donor
- 分子
- Direction reproducibility 的事件/阳性数量
- 分母
- 本项纳入的 cell dynamics checked across genes and samples
- 统计单位
- cell dynamics checked across genes and samples
- 单位
- donors
固定种子教学摘要;cell-state arrow
可按脚本复算
- PASS5/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW5/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 rna-velocity 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Direction reproducibility: bootstrap 后方向相同 donor / donor; observed=5/6; compare=当前数据 P10–P90 与 leave-one-out.cell-state arrow 的教学值为 5/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Direction reproducibility 已给出观测值 5/6、单位 donors 与统计范围 cell-state arrow;快速筛查通过,但仍需保留敏感性结果。
04Latent time range需要情境化复核
指标 · Latent time range
模型 latent time 的 P5–P95
- 分子
- Latent time range 的事件/阳性数量
- 分母
- 本项纳入的 cell dynamics checked across genes and samples
- 统计单位
- cell dynamics checked across genes and samples
- 单位
- scaled time
固定种子教学摘要;not clock time
可按脚本复算
- PASS0.08–0.91 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 rna-velocity 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Latent time range: 模型 latent time 的 P5–P95; observed=0.08–0.91; compare=当前数据 P10–P90 与 leave-one-out.not clock time 的教学值为 0.08–0.91;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Latent time range 已给出观测值 0.08–0.91、单位 scaled time 与统计范围 not clock time;需要补充 donor/模型诊断后再解释。
05Observed time需要情境化复核
指标 · Observed time
真实采样时间点是否记录
- 分子
- Observed time 的事件/阳性数量
- 分母
- 本项纳入的 cell dynamics checked across genes and samples
- 统计单位
- cell dynamics checked across genes and samples
- 单位
- not measured
固定种子教学摘要;auxiliary pancreas data
原始对象未提供,不能替换为经验阈值
- PASS资料可用后再判断;当前不能把缺失数据当作通过。
- REVIEW输入层缺失;显示 unavailable,不输出数值结论。
- STOP数据对象不存在或统计单位不匹配时停止下游解释。
适用范围:数值仅绑定 rna-velocity 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Observed time: 真实采样时间点是否记录; observed=unavailable; compare=当前数据 P10–P90 与 leave-one-out.auxiliary pancreas data 的教学值为 unavailable;由于没有输入对象,页面明确标记 unavailable,不能输出通过结论。
Observed time 的原始输入缺失;当前只能说明缺口,不能以“合理”或“稳定”代替计算。
先锁定 cell dynamics checked across genes and samples,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
缺少 layers、相图不符合模型、低 confidence、箭头被单一基因或边界效应主导时停止方向解释。
回到 spliced/unspliced count layers、邻居图与细胞状态 定位冲突来自哪个独立单位,并用 scVelo dynamical model 的诊断输出复算;冲突未解释前只保留描述性结果。
支持近期转录变化方向的模型化候选。
不能证明真实迁移、发育时间、最终命运或肺纤维化中的同一过程。
VALIDATION · 下一层证据
- 留出至少一个 cell dynamics checked across genes and samples 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- spliced/unspliced count layers、邻居图与细胞状态;donor / condition metadata
- 预期输出
- velocity vectors、latent time 与 gene diagnostics;可审计诊断摘要
- 验证 layers 与基因覆盖
- 预处理 moments
- 拟合稳态或动态模型
- 查看 gene-level phase portraits
- 比较方向与已知谱系
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- spliced/unspliced count layers、邻居图与细胞状态;donor / condition metadata
- 预期输出
- velocity vectors、latent time 与 gene diagnostics;可审计诊断摘要
- 验证 layers 与基因覆盖
- 预处理 moments
- 拟合稳态或动态模型
- 查看 gene-level phase portraits
- 比较方向与已知谱系
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持近期转录变化方向的模型化候选。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cell dynamics checked across genes and samples 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 scVelo dynamical model 误差来源的测量,最能区分技术解释与生物解释?
从局部方向到命运概率
QUESTION怎样把局部转移方向汇总为到达候选终末状态的概率?
INTUITION · 先建立直觉
像根据道路网络与当前车流估计更可能到达哪个终点;概率不是已经发生的行程。类比不是命运证据。
CLINICAL CASE · 肺纤维化情境
同样使用胰腺辅助数据演示 CellRank;肺纤维化若无可靠 velocity 或时间信息,不能直接移植命运结论。
WHY / PRINCIPLE
Cell fate 继承上游 kernel 与终末状态假设的不确定性;概率分布必须与生物先验和数据覆盖一起解释。
WORKFLOW · 数据怎样变化
- 01构建并诊断 kernel
- 02识别宏状态
- 03定义/验证初始终末状态
- 04计算吸收概率
- 05寻找并验证 driver
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R deterministic neighbor-graph teaching generator v1
- HASH
0ceb10104535…
逐项核对数值、适用条件与下一步
01Initial state通过快速筛查
指标 · Initial state
起点状态被模型识别的细胞 / 起点细胞
- 分子
- Initial state 的事件/阳性数量
- 分母
- 本项纳入的 cell probabilities with state-level validation
- 统计单位
- cell probabilities with state-level validation
- 单位
- %
固定种子教学摘要;CellRank root
可按脚本复算
- PASS410/460 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-fate 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Initial state: 起点状态被模型识别的细胞 / 起点细胞; observed=410/460; compare=当前数据 P10–P90 与 leave-one-out.CellRank root 的教学值为 410/460;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Initial state 已给出观测值 410/460、单位 % 与统计范围 CellRank root;快速筛查通过,但仍需保留敏感性结果。
02Terminal fate probability通过快速筛查
指标 · Terminal fate probability
目标终点的平均吸收概率
- 分子
- Terminal fate probability 的事件/阳性数量
- 分母
- 本项纳入的 cell probabilities with state-level validation
- 统计单位
- cell probabilities with state-level validation
- 单位
- probability
固定种子教学摘要;fibroblast-like terminal
可按脚本复算
- PASS0.68 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-fate 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Terminal fate probability: 目标终点的平均吸收概率; observed=0.68; compare=当前数据 P10–P90 与 leave-one-out.fibroblast-like terminal 的教学值为 0.68;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Terminal fate probability 已给出观测值 0.68、单位 probability 与统计范围 fibroblast-like terminal;快速筛查通过,但仍需保留敏感性结果。
03Fate uncertainty通过快速筛查
指标 · Fate uncertainty
最大与第二概率差的中位数
- 分子
- Fate uncertainty 的事件/阳性数量
- 分母
- 本项纳入的 cell probabilities with state-level validation
- 统计单位
- cell probabilities with state-level validation
- 单位
- probability gap
固定种子教学摘要;per cell
可按脚本复算
- PASS0.31 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-fate 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Fate uncertainty: 最大与第二概率差的中位数; observed=0.31; compare=当前数据 P10–P90 与 leave-one-out.per cell 的教学值为 0.31;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Fate uncertainty 已给出观测值 0.31、单位 probability gap 与统计范围 per cell;快速筛查通过,但仍需保留敏感性结果。
04Donor recurrence需要情境化复核
指标 · Donor recurrence
同一方向 donor / donor
- 分子
- Donor recurrence 的事件/阳性数量
- 分母
- 本项纳入的 cell probabilities with state-level validation
- 统计单位
- cell probabilities with state-level validation
- 单位
- donors
固定种子教学摘要;fate map
可按脚本复算
- PASS5/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW5/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-fate 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Donor recurrence: 同一方向 donor / donor; observed=5/6; compare=当前数据 P10–P90 与 leave-one-out.fate map 的教学值为 5/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Donor recurrence 已给出观测值 5/6、单位 donors 与统计范围 fate map;需要补充 donor/模型诊断后再解释。
05Perturbation evidence需要情境化复核
指标 · Perturbation evidence
是否有干预/lineage tracing
- 分子
- Perturbation evidence 的事件/阳性数量
- 分母
- 本项纳入的 cell probabilities with state-level validation
- 统计单位
- cell probabilities with state-level validation
- 单位
- not measured
固定种子教学摘要;inference only
原始对象未提供,不能替换为经验阈值
- PASS资料可用后再判断;当前不能把缺失数据当作通过。
- REVIEW输入层缺失;显示 unavailable,不输出数值结论。
- STOP数据对象不存在或统计单位不匹配时停止下游解释。
适用范围:数值仅绑定 cell-fate 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Perturbation evidence: 是否有干预/lineage tracing; observed=unavailable; compare=当前数据 P10–P90 与 leave-one-out.inference only 的教学值为 unavailable;由于没有输入对象,页面明确标记 unavailable,不能输出通过结论。
Perturbation evidence 的原始输入缺失;当前只能说明缺口,不能以“合理”或“稳定”代替计算。
先锁定 cell probabilities with state-level validation,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
终末状态靠人工强定、概率随 kernel 大幅改变、数据不覆盖过渡区或上游 velocity 不可靠时停止。
回到 transition kernel、initial/terminal state assumptions 定位冲突来自哪个独立单位,并用 CellRank transition kernels 的诊断输出复算;冲突未解释前只保留描述性结果。
支持候选终末状态与相对命运倾向的模型化排序。
不能证明单个细胞未来必然走向某命运。
VALIDATION · 下一层证据
- 留出至少一个 cell probabilities with state-level validation 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- transition kernel、initial/terminal state assumptions;donor / condition metadata
- 预期输出
- macrostates、fate probabilities、driver candidates;可审计诊断摘要
- 构建并诊断 kernel
- 识别宏状态
- 定义/验证初始终末状态
- 计算吸收概率
- 寻找并验证 driver
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- transition kernel、initial/terminal state assumptions;donor / condition metadata
- 预期输出
- macrostates、fate probabilities、driver candidates;可审计诊断摘要
- 构建并诊断 kernel
- 识别宏状态
- 定义/验证初始终末状态
- 计算吸收概率
- 寻找并验证 driver
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持候选终末状态与相对命运倾向的模型化排序。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cell probabilities with state-level validation 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 CellRank transition kernels 误差来源的测量,最能区分技术解释与生物解释?
调控网络是候选关系而非直接结合
QUESTION共表达、motif 与调控子活性如何共同提出转录因子—靶基因假设?
INTUITION · 先建立直觉
像从多人发言的同步变化推测谁在协调议题;同步不等于直接下达指令。类比不是调控证据。
CLINICAL CASE · 肺纤维化情境
纤维化成纤维细胞可能显示某 TF regulon 活性升高,但需要染色质结合或扰动验证直接调控。
WHY / PRINCIPLE
GRN 推断结合统计依赖和先验数据库;网络边是候选调控关系,受稀疏性与细胞组成影响。
WORKFLOW · 数据怎样变化
- 01推断共表达候选
- 02用 motif/先验过滤
- 03计算 regulon activity
- 04按 donor 比较
- 05用 ChIP/ATAC/扰动验证
R 生成的原创教学模拟;没有复制论文图,也不承载真实肺纤维化研究结论。
- DATASET
- 原创教学模拟
- GENERATOR
- R deterministic neighbor-graph teaching generator v1
- HASH
0ceb10104535…
逐项核对数值、适用条件与下一步
01Regulator target count通过快速筛查
指标 · Regulator target count
网络中通过阈值的 target gene 数
- 分子
- Regulator target count 的事件/阳性数量
- 分母
- 本项纳入的 cells for activity; donors for condition comparison
- 统计单位
- cells for activity; donors for condition comparison
- 单位
- genes
固定种子教学摘要;SCENIC regulon
可按脚本复算
- PASS34 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 grn 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Regulator target count: 网络中通过阈值的 target gene 数; observed=34; compare=当前数据 P10–P90 与 leave-one-out.SCENIC regulon 的教学值为 34;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Regulator target count 已给出观测值 34、单位 genes 与统计范围 SCENIC regulon;快速筛查通过,但仍需保留敏感性结果。
02Regulon activity effect通过快速筛查
指标 · Regulon activity effect
IPF 与 control donor-level activity 差
- 分子
- Regulon activity effect 的事件/阳性数量
- 分母
- 本项纳入的 cells for activity; donors for condition comparison
- 统计单位
- cells for activity; donors for condition comparison
- 单位
- z-score
固定种子教学摘要;regulon score
可按脚本复算
- PASS0.56 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 grn 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Regulon activity effect: IPF 与 control donor-level activity 差; observed=0.56; compare=当前数据 P10–P90 与 leave-one-out.regulon score 的教学值为 0.56;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Regulon activity effect 已给出观测值 0.56、单位 z-score 与统计范围 regulon score;快速筛查通过,但仍需保留敏感性结果。
03Donor recurrence通过快速筛查
指标 · Donor recurrence
方向一致 donor / donor
- 分子
- Donor recurrence 的事件/阳性数量
- 分母
- 本项纳入的 cells for activity; donors for condition comparison
- 统计单位
- cells for activity; donors for condition comparison
- 单位
- donors
固定种子教学摘要;FOXM1 regulon
可按脚本复算
- PASS5/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW5/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 grn 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Donor recurrence: 方向一致 donor / donor; observed=5/6; compare=当前数据 P10–P90 与 leave-one-out.FOXM1 regulon 的教学值为 5/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Donor recurrence 已给出观测值 5/6、单位 donors 与统计范围 FOXM1 regulon;快速筛查通过,但仍需保留敏感性结果。
04Motif support需要情境化复核
指标 · Motif support
有 motif/peak 支持的 target / predicted target
- 分子
- Motif support 的事件/阳性数量
- 分母
- 本项纳入的 cells for activity; donors for condition comparison
- 统计单位
- cells for activity; donors for condition comparison
- 单位
- %
固定种子教学摘要;motif support
可按脚本复算
- PASS18/34 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 grn 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Motif support: 有 motif/peak 支持的 target / predicted target; observed=18/34; compare=当前数据 P10–P90 与 leave-one-out.motif support 的教学值为 18/34;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Motif support 已给出观测值 18/34、单位 % 与统计范围 motif support;需要补充 donor/模型诊断后再解释。
05Direct binding需要情境化复核
指标 · Direct binding
是否有 ChIP/perturbation 直接证据
- 分子
- Direct binding 的事件/阳性数量
- 分母
- 本项纳入的 cells for activity; donors for condition comparison
- 统计单位
- cells for activity; donors for condition comparison
- 单位
- not measured
固定种子教学摘要;network prediction
原始对象未提供,不能替换为经验阈值
- PASS资料可用后再判断;当前不能把缺失数据当作通过。
- REVIEW输入层缺失;显示 unavailable,不输出数值结论。
- STOP数据对象不存在或统计单位不匹配时停止下游解释。
适用范围:数值仅绑定 grn 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Direct binding: 是否有 ChIP/perturbation 直接证据; observed=unavailable; compare=当前数据 P10–P90 与 leave-one-out.network prediction 的教学值为 unavailable;由于没有输入对象,页面明确标记 unavailable,不能输出通过结论。
Direct binding 的原始输入缺失;当前只能说明缺口,不能以“合理”或“稳定”代替计算。
先锁定 cells for activity; donors for condition comparison,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
网络仅由共表达、批次或细胞类型组成驱动,或关键边在先验和数据中不稳定时暂停。
回到 expression matrix、TF list、motif/target database 定位冲突来自哪个独立单位,并用 SCENIC/pySCENIC 的诊断输出复算;冲突未解释前只保留描述性结果。
支持优先排序候选 TF 程序与靶基因集合。
不能单独证明 TF 直接结合或导致疾病表型。
VALIDATION · 下一层证据
- 留出至少一个 cells for activity; donors for condition comparison 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- expression matrix、TF list、motif/target database;donor / condition metadata
- 预期输出
- regulons、activity scores 与 candidate edges;可审计诊断摘要
- 推断共表达候选
- 用 motif/先验过滤
- 计算 regulon activity
- 按 donor 比较
- 用 ChIP/ATAC/扰动验证
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- expression matrix、TF list、motif/target database;donor / condition metadata
- 预期输出
- regulons、activity scores 与 candidate edges;可审计诊断摘要
- 推断共表达候选
- 用 motif/先验过滤
- 计算 regulon activity
- 按 donor 比较
- 用 ChIP/ATAC/扰动验证
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持优先排序候选 TF 程序与靶基因集合。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 cells for activity; donors for condition comparison 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 SCENIC/pySCENIC 误差来源的测量,最能区分技术解释与生物解释?
配体—受体预测怎样形成可验证假设
QUESTION哪些细胞群之间存在值得验证的配体—受体候选关系?
INTUITION · 先建立直觉
像通讯录显示两人可能联系:有号码与在线状态仍不代表消息已经发送、更不代表产生了结果。类比不是通讯证据。
CLINICAL CASE · 肺纤维化情境
肺巨噬细胞配体与成纤维细胞受体共表达可提示候选轴,但需要空间邻近、蛋白与阻断实验。
WHY / PRINCIPLE
数据库与表达规则推断潜在通讯;群体大小、ambient RNA、注释和数据库选择都会改变网络。
WORKFLOW · 数据怎样变化
- 01验证 ligand/receptor 表达
- 02按 donor 计算候选
- 03控制群体大小和背景
- 04比较工具/数据库
- 05设计空间与阻断验证
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · donor-level composition from public metadata
- HASH
a5ec477bb39f…
逐项核对数值、适用条件与下一步
01Ligand–receptor support通过快速筛查
指标 · Ligand–receptor support
表达且通过数据库过滤的 pair / tested pairs
- 分子
- Ligand–receptor support 的事件/阳性数量
- 分母
- 本项纳入的 donor for condition comparison; cell type pairs for hypotheses
- 统计单位
- donor for condition comparison; cell type pairs for hypotheses
- 单位
- %
固定种子教学摘要;CellChat candidates
可按脚本复算
- PASS12/84 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-communication 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Ligand–receptor support: 表达且通过数据库过滤的 pair / tested pairs; observed=12/84; compare=当前数据 P10–P90 与 leave-one-out.CellChat candidates 的教学值为 12/84;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Ligand–receptor support 已给出观测值 12/84、单位 % 与统计范围 CellChat candidates;快速筛查通过,但仍需保留敏感性结果。
02Sender abundance通过快速筛查
指标 · Sender abundance
发送细胞数 / 发送群细胞数
- 分子
- Sender abundance 的事件/阳性数量
- 分母
- 本项纳入的 donor for condition comparison; cell type pairs for hypotheses
- 统计单位
- donor for condition comparison; cell type pairs for hypotheses
- 单位
- %
固定种子教学摘要;macrophage sender
可按脚本复算
- PASS210/640 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-communication 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Sender abundance: 发送细胞数 / 发送群细胞数; observed=210/640; compare=当前数据 P10–P90 与 leave-one-out.macrophage sender 的教学值为 210/640;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Sender abundance 已给出观测值 210/640、单位 % 与统计范围 macrophage sender;快速筛查通过,但仍需保留敏感性结果。
03Receiver response通过快速筛查
指标 · Receiver response
目标程序阳性 receiver / receiver
- 分子
- Receiver response 的事件/阳性数量
- 分母
- 本项纳入的 donor for condition comparison; cell type pairs for hypotheses
- 统计单位
- donor for condition comparison; cell type pairs for hypotheses
- 单位
- %
固定种子教学摘要;fibroblast response
可按脚本复算
- PASS96/380 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-communication 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Receiver response: 目标程序阳性 receiver / receiver; observed=96/380; compare=当前数据 P10–P90 与 leave-one-out.fibroblast response 的教学值为 96/380;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Receiver response 已给出观测值 96/380、单位 % 与统计范围 fibroblast response;快速筛查通过,但仍需保留敏感性结果。
04Donor recurrence需要情境化复核
指标 · Donor recurrence
pair 在 donor 中重复出现 / donor
- 分子
- Donor recurrence 的事件/阳性数量
- 分母
- 本项纳入的 donor for condition comparison; cell type pairs for hypotheses
- 统计单位
- donor for condition comparison; cell type pairs for hypotheses
- 单位
- donors
固定种子教学摘要;per-donor summary
可按脚本复算
- PASS5/6;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW5/6 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 cell-communication 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Donor recurrence: pair 在 donor 中重复出现 / donor; observed=5/6; compare=当前数据 P10–P90 与 leave-one-out.per-donor summary 的教学值为 5/6;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Donor recurrence 已给出观测值 5/6、单位 donors 与统计范围 per-donor summary;需要补充 donor/模型诊断后再解释。
05Perturbation evidence需要情境化复核
指标 · Perturbation evidence
是否有阻断/配体实验
- 分子
- Perturbation evidence 的事件/阳性数量
- 分母
- 本项纳入的 donor for condition comparison; cell type pairs for hypotheses
- 统计单位
- donor for condition comparison; cell type pairs for hypotheses
- 单位
- not measured
固定种子教学摘要;prediction only
原始对象未提供,不能替换为经验阈值
- PASS资料可用后再判断;当前不能把缺失数据当作通过。
- REVIEW输入层缺失;显示 unavailable,不输出数值结论。
- STOP数据对象不存在或统计单位不匹配时停止下游解释。
适用范围:数值仅绑定 cell-communication 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Perturbation evidence: 是否有阻断/配体实验; observed=unavailable; compare=当前数据 P10–P90 与 leave-one-out.prediction only 的教学值为 unavailable;由于没有输入对象,页面明确标记 unavailable,不能输出通过结论。
Perturbation evidence 的原始输入缺失;当前只能说明缺口,不能以“合理”或“稳定”代替计算。
先锁定 donor for condition comparison; cell type pairs for hypotheses,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
网络毛线团、候选来自极少细胞或单 donor、缺少空间邻域富集比、置换 FDR 或可执行验证时停止功能叙述。
回到 cell labels、ligand/receptor expression、database、donor 定位冲突来自哪个独立单位,并用 CellChat/CellPhoneDB 的诊断输出复算;冲突未解释前只保留描述性结果。
支持优先排序候选发送—接收关系。
不能单独证明配体释放、受体激活、信号方向、功能作用或因果。
VALIDATION · 下一层证据
- 留出至少一个 donor for condition comparison; cell type pairs for hypotheses 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- cell labels、ligand/receptor expression、database、donor;donor / condition metadata
- 预期输出
- sender–receiver candidates、scores 与可验证优先级;可审计诊断摘要
- 验证 ligand/receptor 表达
- 按 donor 计算候选
- 控制群体大小和背景
- 比较工具/数据库
- 设计空间与阻断验证
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- cell labels、ligand/receptor expression、database、donor;donor / condition metadata
- 预期输出
- sender–receiver candidates、scores 与可验证优先级;可审计诊断摘要
- 验证 ligand/receptor 表达
- 按 donor 计算候选
- 控制群体大小和背景
- 比较工具/数据库
- 设计空间与阻断验证
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持优先排序候选发送—接收关系。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 donor for condition comparison; cell type pairs for hypotheses 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 CellChat/CellPhoneDB 误差来源的测量,最能区分技术解释与生物解释?
Part VI · 回到实验验证
把计算关联逐级连接到空间、蛋白、扰动、rescue 与独立队列。
从计算关联回到实验验证
QUESTION如何把单细胞候选从关联逐步升级为空间、蛋白、功能与因果证据?
INTUITION · 先建立直觉
像法庭证据链:线索定位嫌疑,独立证人、物证、干预与重复验证逐层增强结论;单一线索不能直接定案。类比不是因果证明。
CLINICAL CASE · 肺纤维化情境
若 IPF 成纤维细胞显示候选通路,应依次验证组织定位、蛋白、扰动表型、rescue 与独立队列,而非停在漂亮 UMAP。
WHY / PRINCIPLE
证据梯度从计算关联到空间共定位、蛋白、扰动、rescue 与独立样本;每层回答不同问题。
WORKFLOW · 数据怎样变化
- 01计算关联与效应量
- 02空间定位候选细胞/分子
- 03蛋白层验证
- 04perturbation 测试必要性/充分性
- 05rescue 与独立队列复现
GSE135893 公开数据派生;浏览器图只使用固定分层子集,供体级结论不以展示子集计算。
- DATASET
- GSE135893
- GENERATOR
- R 4.5.3 · donor-level composition from public metadata
- HASH
a5ec477bb39f…
逐项核对数值、适用条件与下一步
01Spatial colocalization通过快速筛查
指标 · Spatial colocalization
目标细胞在空间邻域中的重叠 / 目标细胞
- 分子
- Spatial colocalization 的事件/阳性数量
- 分母
- 本项纳入的 independent donors/biological replicates
- 统计单位
- independent donors/biological replicates
- 单位
- %
固定种子教学摘要;spatial transcriptomics
可按脚本复算
- PASS128/210 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 validation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Spatial colocalization: 目标细胞在空间邻域中的重叠 / 目标细胞; observed=128/210; compare=当前数据 P10–P90 与 leave-one-out.spatial transcriptomics 的教学值为 128/210;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Spatial colocalization 已给出观测值 128/210、单位 % 与统计范围 spatial transcriptomics;快速筛查通过,但仍需保留敏感性结果。
02Protein concordance通过快速筛查
指标 · Protein concordance
蛋白阳性与 RNA 高表达样本 / paired samples
- 分子
- Protein concordance 的事件/阳性数量
- 分母
- 本项纳入的 independent donors/biological replicates
- 统计单位
- independent donors/biological replicates
- 单位
- samples
固定种子教学摘要;IF/IHC
可按脚本复算
- PASS5/7;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW5/7 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 validation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Protein concordance: 蛋白阳性与 RNA 高表达样本 / paired samples; observed=5/7; compare=当前数据 P10–P90 与 leave-one-out.IF/IHC 的教学值为 5/7;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Protein concordance 已给出观测值 5/7、单位 samples 与统计范围 IF/IHC;快速筛查通过,但仍需保留敏感性结果。
03Perturbation effect通过快速筛查
指标 · Perturbation effect
干预组与对照组预设终点差
- 分子
- Perturbation effect 的事件/阳性数量
- 分母
- 本项纳入的 independent donors/biological replicates
- 统计单位
- independent donors/biological replicates
- 单位
- standardized units
固定种子教学摘要;in vitro fibrosis assay
可按脚本复算
- PASS−0.44 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 validation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Perturbation effect: 干预组与对照组预设终点差; observed=−0.44; compare=当前数据 P10–P90 与 leave-one-out.in vitro fibrosis assay 的教学值为 −0.44;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Perturbation effect 已给出观测值 −0.44、单位 standardized units 与统计范围 in vitro fibrosis assay;快速筛查通过,但仍需保留敏感性结果。
04Rescue fraction需要情境化复核
指标 · Rescue fraction
rescue 恢复的干预损失 / 原始损失
- 分子
- Rescue fraction 的事件/阳性数量
- 分母
- 本项纳入的 independent donors/biological replicates
- 统计单位
- independent donors/biological replicates
- 单位
- fraction
固定种子教学摘要;rescue experiment
可按脚本复算
- PASS0.62 与预先登记的比较基准一致,且分母、统计单位和计算脚本可复核。
- REVIEW数值落在当前数据的 P10–P90 之外,或 leave-one-unit-out 后改变超过 20%;进入情境化复核。
- STOP分母缺失、指标在相邻参数/重采样中改变超过 35% 时停止,把结果降为描述性。
适用范围:数值仅绑定 validation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Rescue fraction: rescue 恢复的干预损失 / 原始损失; observed=0.62; compare=当前数据 P10–P90 与 leave-one-out.rescue experiment 的教学值为 0.62;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Rescue fraction 已给出观测值 0.62、单位 fraction 与统计范围 rescue experiment;需要补充 donor/模型诊断后再解释。
05Independent cohort通过快速筛查
指标 · Independent cohort
复制方向 cohort / 复制 cohort
- 分子
- Independent cohort 的事件/阳性数量
- 分母
- 本项纳入的 independent donors/biological replicates
- 统计单位
- independent donors/biological replicates
- 单位
- cohorts
固定种子教学摘要;external validation
可按脚本复算
- PASS2/3;同时要求每个 donor 的方向和效应量均可追溯。
- REVIEW2/3 之外仍有 1–2 个 donor 缺失或方向相反,改为 donor 分层并做敏感性分析。
- STOP分母缺失、有效 donor 少于 3 个 时停止,把结果降为描述性。
适用范围:数值仅绑定 validation 的教学数据与统计单位;正式分析必须用当前 donor/sample 分布、模型输出和预注册比较基准替换。
联合因素:统计单位 · 分母 · 重复/重采样 · 独立验证
Independent cohort: 复制方向 cohort / 复制 cohort; observed=2/3; compare=当前数据 P10–P90 与 leave-one-out.external validation 的教学值为 2/3;先按分子/分母计算,再检查 donor 覆盖和敏感性。
Independent cohort 已给出观测值 2/3、单位 cohorts 与统计范围 external validation;快速筛查通过,但仍需保留敏感性结果。
先锁定 independent donors/biological replicates,逐项记录分子、分母与比较基准;只有相邻检查没有出现 stop,才进入下一分析对象。
只有计算相关、缺少生物重复、对照失败、扰动毒性或 rescue 不成立时不能升级因果表述。
回到 candidate cell state/gene/pathway 与明确的因果假设 定位冲突来自哪个独立单位,并用 spatial/IHC validation 的诊断输出复算;冲突未解释前只保留描述性结果。
支持按证据层级逐步增强机制与因果主张。
任何单一 assay 都不能自动证明完整疾病机制或临床有效性。
VALIDATION · 下一层证据
- 留出至少一个 independent donors/biological replicates 重算效应、方向与诊断量,并报告变化幅度。
- 增加不共享同一误差来源的正交测量;若两层证据冲突,先解释冲突而不是投票。
REPRODUCE · 代码与复现R / Python
R · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- candidate cell state/gene/pathway 与明确的因果假设;donor / condition metadata
- 预期输出
- 分层验证设计、预注册 readout 与结论边界;可审计诊断摘要
- 计算关联与效应量
- 空间定位候选细胞/分子
- 蛋白层验证
- perturbation 测试必要性/充分性
- rescue 与独立队列复现
Python · 分析实施要求
本节目前提供输入、步骤和验收要求;完整执行脚本尚未提供。
- 准备输入
- candidate cell state/gene/pathway 与明确的因果假设;donor / condition metadata
- 预期输出
- 分层验证设计、预注册 readout 与结论边界;可审计诊断摘要
- 计算关联与效应量
- 空间定位候选细胞/分子
- 蛋白层验证
- perturbation 测试必要性/充分性
- rescue 与独立队列复现
TAKE HOME
先写清本章数据对象如何由上一步生成,再解释图形。
任何通过/复核/停止判断都必须同时保存分子、分母、统计单位和适用范围。
方法输出是证据的一层;结论强度不能超过 支持按证据层级逐步增强机制与因果主张。
THINK · 先判断,再继续
- 如果合并图不变,但只有一半 independent donors/biological replicates 同方向,你会把结论降到哪一层?
- 新增哪一种不共享 spatial/IHC validation 误差来源的测量,最能区分技术解释与生物解释?
把 22 章判断重新放回 Figure、参数与完整研究问题
以下区域不再引入新的方法清单,而是训练反向追踪、读图、参数敏感性与结论边界。
一张多 Panel Figure 是怎么得到的?
选择 A–D Panel,先读编码,再反向追到分析结果、矩阵、FASTQ、测序和样本。
Cellular landscape of pulmonary fibrosis
MedResearch Atlas Teaching Dataset · 2026 · Figure 2
模拟图用于控制变量;真实图用于学习不规则分布、拥挤 Panel 和论文上下文。两者不混作同一种来源。
真实论文 Figure · 保留原图与完整归属
这里用于训练读图,不把论文图改写成本站的研究结果。所有图片均来自 PMC Open Access Subset,并逐张核验 CC BY 4.0。
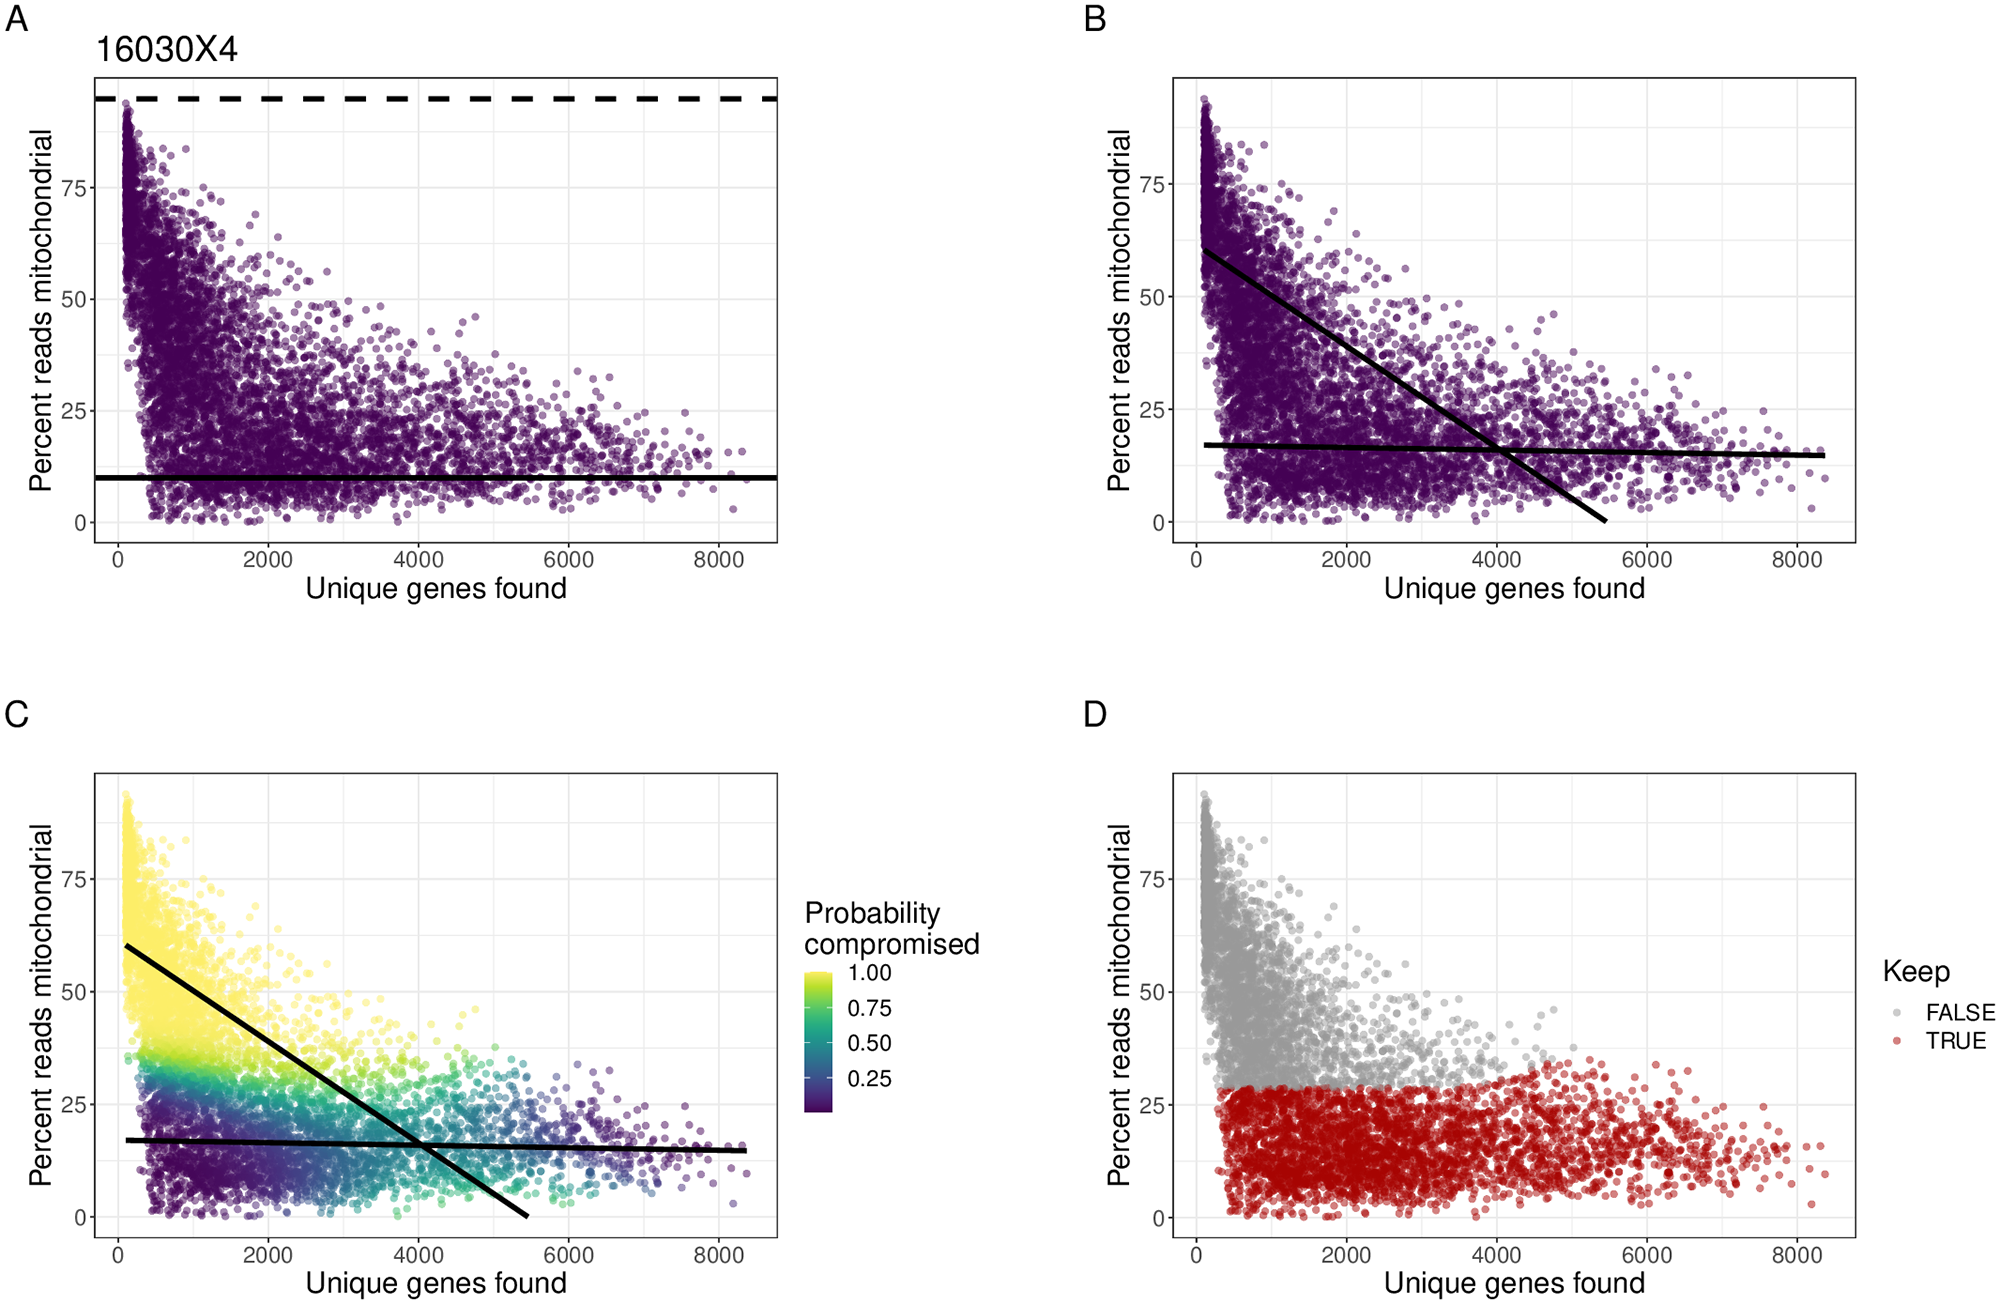 打开本地高清图
本地副本与修改说明
- Publisher-provided large image saved locally
- Responsive display only; panel content was not altered
八类常见单细胞 Figure:如何读,何时停
固定顺序为坐标与编码 → 样本单位 → 主要趋势 → 异常趋势 → 证据边界。
不要先看结论,先建立固定读图顺序
- 1 轴与编码
- 2 全局结构
- 3 组间趋势
- 4 重复与 QC
- 5 证据边界
主要细胞状态如何组织,样本与批次是否共同覆盖这些状态?
按这个顺序读,不要跳步
- 01先看图例确认颜色代表 cluster 还是 sample,确认是否展示全部细胞及各组细胞数。
- 02再看全局结构识别大群、连续过渡、稀有小群和离群岛,但暂不命名细胞类型。
- 03改按样本着色按 donor 计数:若某群由 ≥3/4 donor 贡献且最大单 donor 贡献 ≤80%,可进入下一步;若支持 donor <3/4 或最大贡献 >80%,先回查批次、QC 与抽样。
- 04叠加 QC 与 marker检查小群是否高 percent.mt、低 nFeature,或是否拥有成套正 marker 与负 marker。
- 05回到邻居图聚类来自 neighbor graph,不在二维 UMAP 上按视觉距离手工圈群。
- 主要群体至少由 3/4 donor 贡献,群内最大单 donor 贡献 ≤80%;按 batch 着色时同源邻居率相对置换基线 z-score ≤2,同时已知 condition 的 donor-level 效应方向未被抹平。
- 群体边界能被成套 marker、参考图谱和组织知识重复支持,而不只靠岛屿外形。
- 固定 PCA 后改变 k=20/30/40 与 3 个 seed,细胞邻居 Jaccard 中位数 ≥0.80,且核心群在每档的 ARI ≥0.80。
- 稀有群至少有 20 个细胞、来自 ≥2 个 donor(每个 donor ≥5 个),QC flag 细胞占比 <30%,doublet score 高于模型阈值的细胞 <10%。
- 某群最大单 donor 贡献 >80%,或同源邻居率相对置换基线 z-score >3;这时样本来源比生物标签更能解释邻域结构。
- 所谓新群同时呈现两种互斥谱系 marker,且 nCount 异常高,提示 doublet。
- 小岛只由少量高 percent.mt、低 nFeature 细胞构成,提示受损细胞或环境 RNA。
- 仅凭二维靠得近就推断细胞相互作用、发育先后或空间邻近。
支持描述数据中的表达状态结构、候选细胞群及其样本构成,并为 marker 和下游检验定位对象。
不能单独证明细胞谱系、组织空间距离、细胞通讯、疾病机制或因果关系。
什么时候应该停止解释?若把颜色切换为 sample 后群体结构完全被样本来源替代,先暂停生物学命名,回查批次、QC、整合策略与样本量。
不要只列指标:把证据放回一个判断情境
先用类比建立直觉,再把每项观察放回研究问题,最后决定结论应该停在哪里。
UMAP 像一张带图例的地图
地图不是目的地本身,它只把位置、方向和比例编码出来。读 UMAP 时,先确认每个视觉元素代表什么,再判断哪些趋势可以支持研究问题。
这张 UMAP 真正要回答什么?
情境:研究者用 预处理后的研究数据和样本 metadata 生成 UMAP,想回答“主要细胞状态如何组织,样本与批次是否共同覆盖这些状态?”。
问题:图中的趋势是否在正确的统计单位、样本和不确定性范围内成立?
观察:先观察整体结构,再核对图例、分母、重复和异常点;任何单一视觉趋势都必须回到生成它的数据对象。
先确认 先看图例 编码的是什么
确认颜色代表 cluster 还是 sample,确认是否展示全部细胞及各组细胞数。
主要群体至少由 3/4 donor 贡献,群内最大单 donor 贡献 ≤80%;按 batch 着色时同源邻居率相对置换基线 z-score ≤2,同时已知 condition 的 donor-level 效应方向未被抹平。该数值只适用于 read-1 的 teaching-example,正式研究按当前 donor/sample 分布复核。
某群最大单 donor 贡献 >80%,或同源邻居率相对置换基线 z-score >3;这时样本来源比生物标签更能解释邻域结构。
没有 先看图例 时,不能判断图形变化是生物学趋势还是编码、分母或样本差异造成的。
先看图例 的教学例为 3/4 个独立单位同方向,效应=0.50(95% CI 0.39–0.66);若同方向单位 ≤1/4,停止强解释。
先拆解编码,再看趋势,最后把趋势与样本、效应量和不确定性合并;图形美观不能替代统计与实验设计。
支持描述数据中的表达状态结构、候选细胞群及其样本构成,并为 marker 和下游检验定位对象。
不能单独证明细胞谱系、组织空间距离、细胞通讯、疾病机制或因果关系。
什么时候应该停止继续解释?
若把颜色切换为 sample 后群体结构完全被样本来源替代,先暂停生物学命名,回查批次、QC、整合策略与样本量。
- 不同样本各自形成独立岛屿,或某个 cluster 超过绝大多数细胞来自单一样本。
- 所谓新群同时呈现两种互斥谱系 marker,且 nCount 异常高,提示 doublet。
- 小岛只由少量高 percent.mt、低 nFeature 细胞构成,提示受损细胞或环境 RNA。
参数改变了哪一层证据?
不要问最佳参数是多少;先问参数改变了什么数据关系,以及结论在哪个范围内稳定。
初学者最常见的 8 个错误
沿 Error → Consequence → Better Thinking 检查漂亮 Figure 如何制造过度确定感。
Association ≠ Mechanism ≠ Causality
可以支持什么和不能单独证明什么,必须同时出现。
结果可以支持什么?
不同细胞群存在表达差异
某些基因富集于特定细胞类型
某些细胞状态与疾病状态相关
为机制实验形成可检验假设
不能单独证明什么?
某基因导致疾病
配体受体预测一定代表真实通讯
pseudotime 就是真实细胞演化时间
UMAP 中相邻 cluster 存在直接关系
差异表达基因就是治疗靶点
单细胞数据能够定位细胞状态、组成与通路关联;机制和因果需要空间、蛋白、扰动、rescue 与独立样本组成的验证链。
把方法重新排列为能回答问题的数据链
不要背软件顺序;解释每一步的输入、输出与下一步为什么成立。
候选基因 X 主要由哪一类细胞表达?
请把分析步骤排列成一条能够回答问题的数据链。
科研思维 Quiz
题目检查统计单位、停止信号与证据边界,而不是缩写记忆。
疾病组某个 fibroblast cluster 比例增加,哪个结论最合理?
为什么 raw counts 不应直接用于 UMAP?
PCA、Neighbors、Clustering 和 UMAP 的正确关系是?
提高 resolution 后出现更多 cluster,下一步最合理的是?
pseudotime 最稳妥的解释是?
从 Tissue 回到 Biological Question
任何结果都要能从 Figure 反向说出分析对象、矩阵、样本、统计单位和验证缺口。
Data
数据怎样产生与变化
Method
每一步为什么存在
Figure
结果怎样被看见
Evidence
结论能够走多远
GSE135893 QC 与组成图由公开元数据在本地 R 4.5.3 中确定性生成;其他未绑定真实数据的示意图均标注原创教学模拟,不承载真实生物学结论。Velocity/Fate 的辅助案例不是肺纤维化证据。
参考文献与进一步阅读
References 支撑本章论断;Further Reading 负责下一步学习。两者不混为一谈。
核心方法论文
支撑降维、聚类与主要分析框架的原始方法来源。
Comprehensive Integration of Single-Cell Data
Tim Stuart et al.. Cell, 2019.
为什么推荐:Seurat integration 与 anchor 框架。
DOI 10.1016/j.cell.2019.05.031 PMID 31178118 PMC6687398 查看原文SCANPY: large-scale single-cell gene expression data analysis
F. Alexander Wolf, Philipp Angerer, Fabian J. Theis. Genome Biology, 2018.
为什么推荐:Python 单细胞分析框架。
DOI 10.1186/s13059-017-1382-0 PMID 29409532 PMC5802054 查看原文UMAP: Uniform Manifold Approximation and Projection
Leland McInnes, John Healy, Nathaniel Saul, Lukas Großberger. Journal of Open Source Software, 2018.
为什么推荐:UMAP 的算法目标与可视化边界。
DOI 10.21105/joss.00861 查看原文From Louvain to Leiden: guaranteeing well-connected communities
Vincent A. Traag, Ludo Waltman, Nees Jan van Eck. Scientific Reports, 2019.
为什么推荐:基于邻居图的 Leiden 社区发现。
DOI 10.1038/s41598-019-41695-z PMID 30914743 PMC6435756 查看原文实验与软件官方文档
用于核对当前 pipeline、cell calling 与输出对象定义。
QC 与最佳实践
说明 QC、归一化、聚类和注释为什么必须依赖数据情境。
Current best practices in single-cell RNA-seq analysis: a tutorial
Malte D. Luecken, Fabian J. Theis. Molecular Systems Biology, 2019.
为什么推荐:教程型 best practices。
DOI 10.15252/msb.20188746 PMID 31217225 PMC6582955 查看原文miQC: An adaptive probabilistic framework for quality control of single-cell RNA-sequencing data
Ariel A. Hippen et al.. PLOS Computational Biology, 2021.
为什么推荐:真实 QC 联合分布、概率过滤与群体组成影响。
DOI 10.1371/journal.pcbi.1009290 PMID 34428202 PMC8415599 查看原文真实 Figure 来源
页面内嵌 CC BY 真实论文 Figure 的论文级来源与教学用途。
miQC: An adaptive probabilistic framework for quality control of single-cell RNA-sequencing data
Ariel A. Hippen et al.. PLOS Computational Biology, 2021.
为什么推荐:Fig. 1 与 Fig. 5:真实 QC 分布和不规则 UMAP。
DOI 10.1371/journal.pcbi.1009290 PMID 34428202 PMC8415599 查看原文